Blackwell을 이해할 때 GPU 한 장의 최고 성능만 보면 중요한 변화가 빠집니다.
NVIDIA는 GPU·HBM·NVLink·CPU·네트워크·소프트웨어를 랙 단위로 묶어 수십 개 GPU가 하나의 큰 AI 컴퓨터처럼 움직이게 하는 방향으로 가고 있습니다.
그래서 Blackwell은 칩 세대이면서 동시에 데이터센터 구조의 변화이기도 합니다.
GPU가 계산 작업자라면 HBM은 작업대, NVLink는 작업자끼리 직접 연결하는 초고속 통로입니다.
GPU가 아무리 빨라도 데이터 공급과 GPU 간 통신이 느리면 비싼 가속기가 기다립니다.
투자 관점에서는 Blackwell의 사양보다 실제 랙 배치가 늘고 GPU·네트워크·시스템 매출이 함께 커지며 높은 마진과 현금흐름으로 이어지는지가 더 중요합니다.
1. Blackwell은 왜 ‘GPU 한 장’보다 랙 전체가 중요할까
대형 AI 모델은 여러 GPU가 같은 작업을 나눠 처리합니다.
모델이 커질수록 GPU 사이에서 이동하는 데이터도 늘기 때문에 서버 몇 대를 단순히 연결하는 방식으로는 효율이 떨어질 수 있습니다.
Blackwell 계열은 GPU와 HBM, NVLink, Grace CPU, 네트워크를 더 긴밀하게 묶습니다.
GB300 NVL72 같은 랙 스케일 시스템은 많은 GPU를 하나의 컴퓨팅 자원처럼 다루는 방향을 보여줍니다.
고객은 GPU 카드만 사는 것이 아니라 랙 단위 AI 처리량을 구매하는 셈입니다.
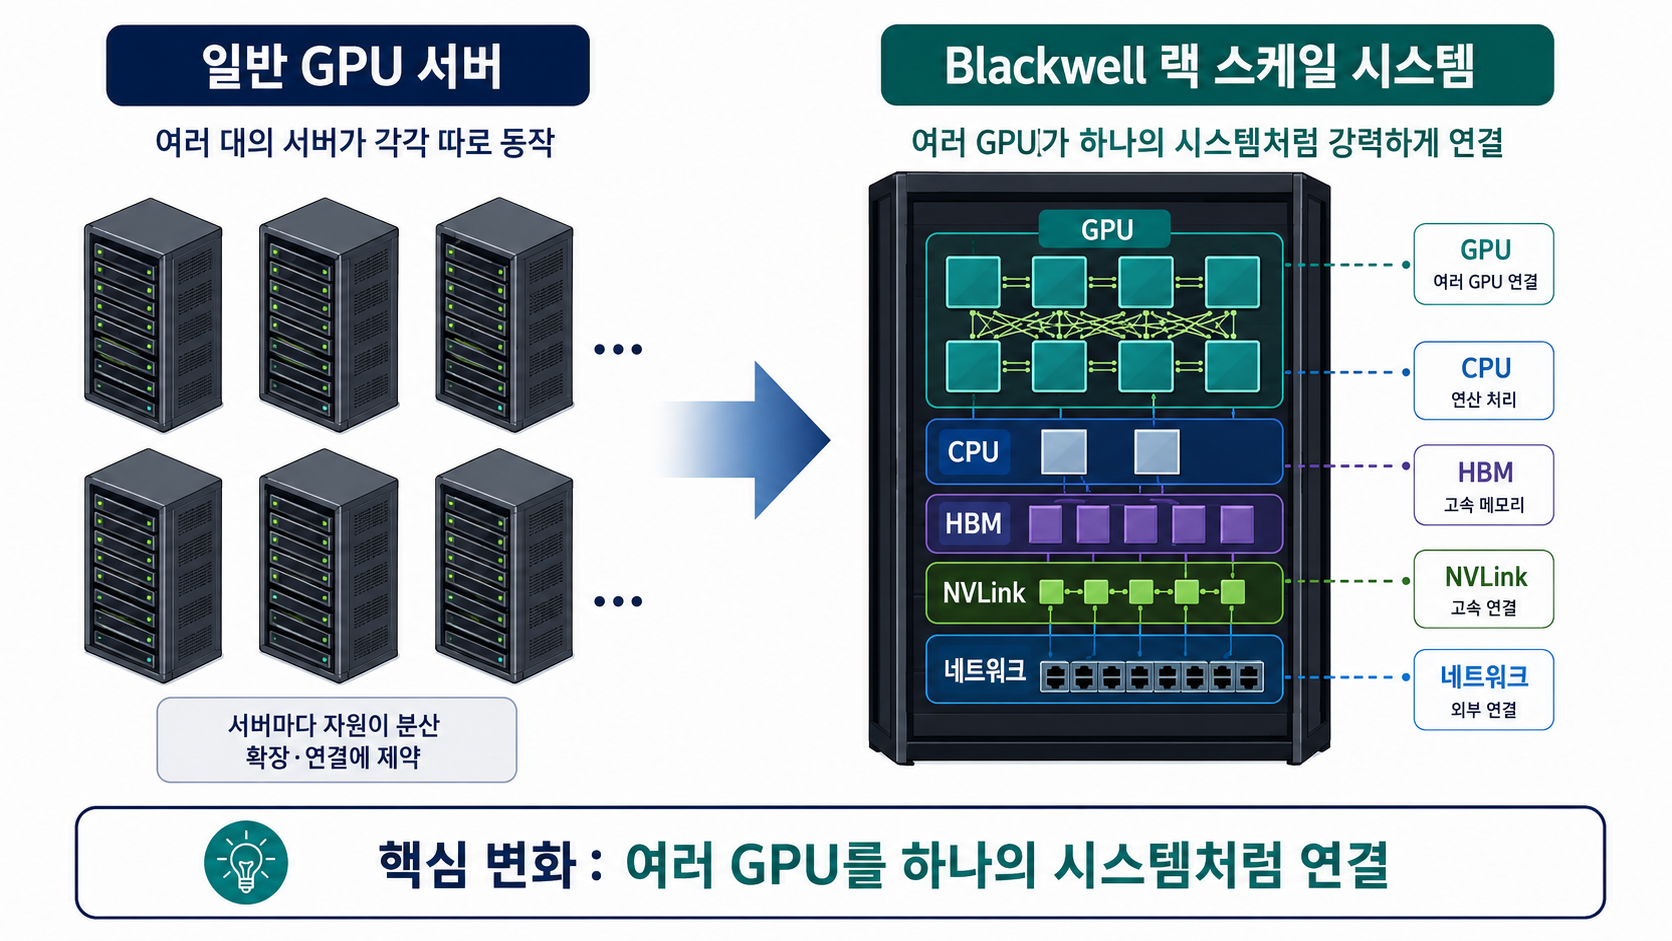
2. HBM·NVLink·전력·냉각이 왜 함께 움직일까
HBM은 GPU 가까이에서 대량의 데이터를 빠르게 공급하고, NVLink는 GPU끼리 데이터를 교환하는 속도를 높입니다.
특히 거대한 모델은 한 GPU 메모리에 들어가지 않기 때문에 메모리 대역폭과 GPU 간 연결이 모두 중요합니다.
문제는 GPU를 수십 개 묶을수록 전력과 발열도 함께 커진다는 점입니다.
그래서 최신 AI 랙은 액체냉각, 더 높은 전력 밀도, 고속 Ethernet·InfiniBand, 안정적인 스토리지 공급까지 요구합니다. Blackwell 도입이 서버 교체를 넘어 데이터센터 인프라 프로젝트가 되는 이유입니다.
GPU → HBM → GPU 간 연결 → 네트워크 → 전력·냉각 중 한 곳만 부족해도 전체 활용률이 떨어질 수 있습니다.
AI 서버 경쟁은 부품 하나보다 시스템 균형의 경쟁에 가깝습니다.

3. Blackwell의 기술 우위는 실적에 어떻게 연결될까
Blackwell이 잘 팔리면 NVIDIA는 GPU만 판매하는 것보다 더 큰 금액을 한 번에 가져갈 수 있습니다.
NVLink, 네트워킹, 랙 시스템과 소프트웨어가 함께 들어가기 때문입니다.
고객이 랙 단위로 구축할수록 NVIDIA가 차지하는 AI 인프라 지출의 범위가 넓어질 수 있습니다.
추론에서는 최고 성능보다 토큰당 비용, 지연시간과 전력 효율이 중요합니다.
Blackwell과 Blackwell Ultra가 낮은 정밀도 연산과 소프트웨어 최적화를 강조하는 것도 실제 서비스 비용을 낮추기 위해서입니다.
| 확인할 지표 | 의미 |
|---|---|
| 데이터센터 매출 | Blackwell 주문이 실제 출하로 이어지는지 |
| 총이익률 | 고부가 GPU·시스템 믹스가 수익성으로 연결되는지 |
| 네트워킹 매출 | GPU를 넘어 전체 AI 시스템 판매가 늘어나는지 |
| FCF | 높은 매출과 마진이 실제 현금으로 남는지 |
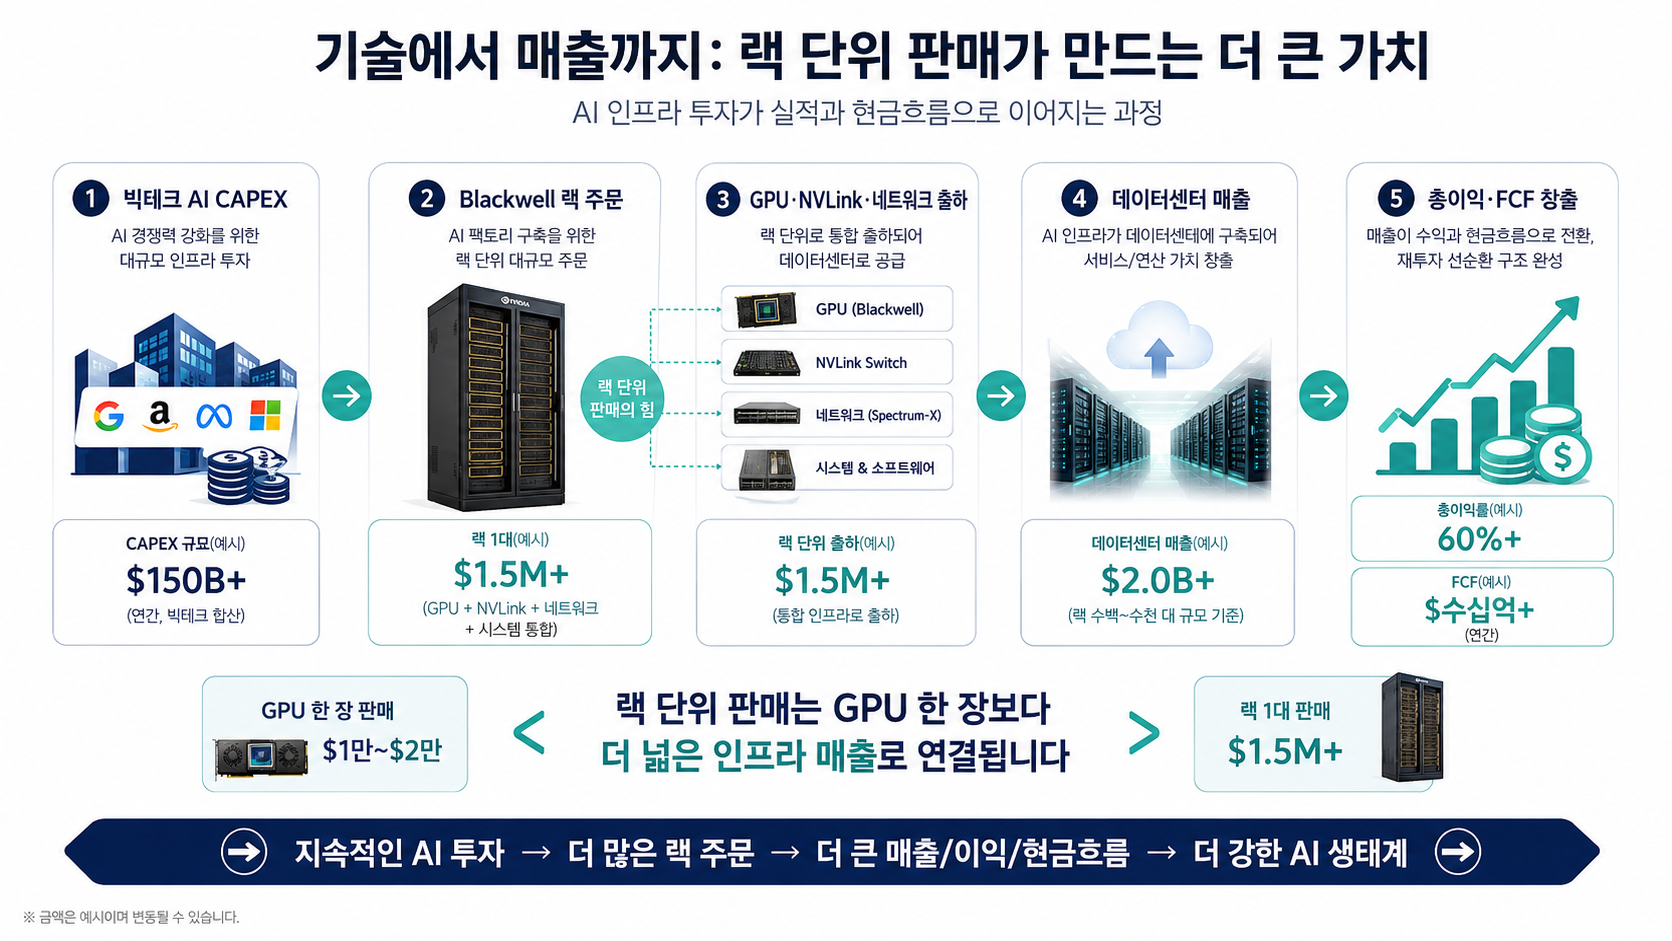
4. 앞으로 어떤 리스크와 시나리오를 보면 될까
가장 큰 변수는 고객 AI CAPEX, HBM·첨단 패키징 공급, 전력·냉각 구축 속도, 수출 규제와 자체칩 확대입니다.
제품 수요가 강해도 데이터센터 전력 연결이 늦거나 차세대 세대 전환이 꼬이면 매출 인식 시점은 늦어질 수 있습니다.
| 시나리오 | 확인되는 변화 |
|---|---|
| 성장 가속 | Blackwell 랙 배치 확대, 네트워크 동반 성장, 높은 총이익률·FCF 유지 |
| 기준 | AI CAPEX는 계속 증가하지만 공급·전력 병목으로 성장률 정상화 |
| 성장 둔화 | 고객 CAPEX 둔화, 자체칩 확대, 제품 전환·공급 지연으로 마진 압박 |
새 GPU 발표보다 기존 고객이 얼마나 빨리 랙 단위로 배치하고, 실제 사용률과 추론 비용이 개선되는지를 보면 플랫폼 경쟁력을 더 정확하게 판단할 수 있습니다.
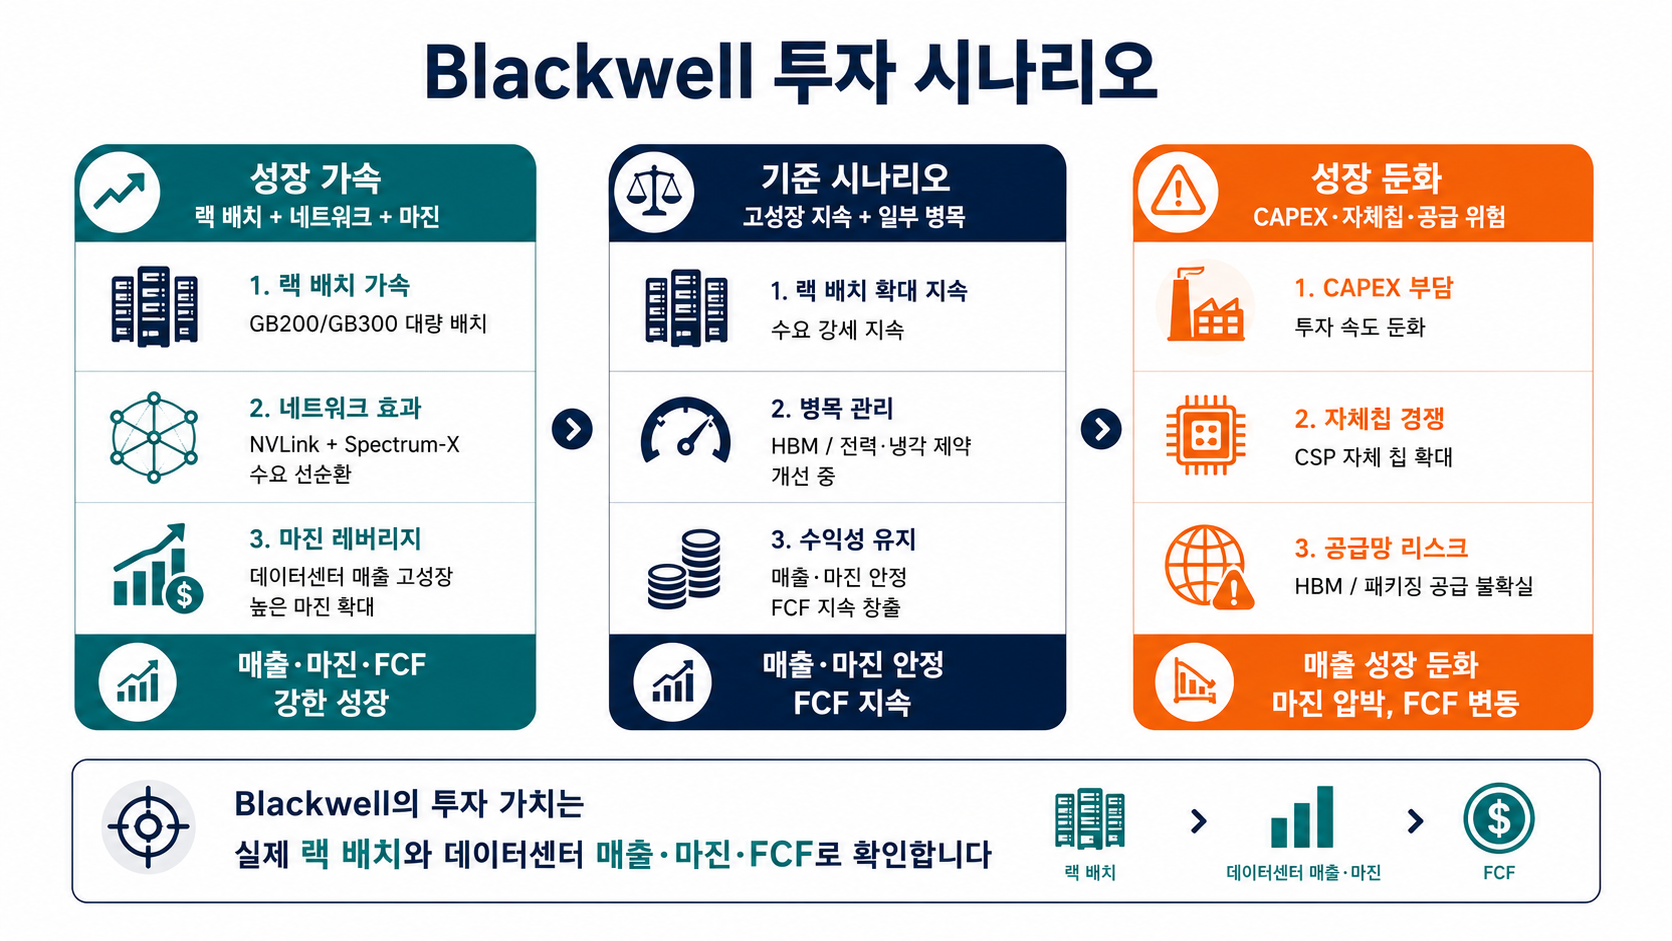
Blackwell의 핵심은 GPU 한 장이 빨라졌다는 데 있지 않습니다.
GPU·HBM·NVLink·네트워크·전력·냉각을 랙 단위로 묶어 더 큰 AI 작업을 높은 활용률로 처리하는 구조가 중요합니다.
투자자는 제품 사양보다 랙 배치 속도, 데이터센터·네트워킹 매출, 총이익률과 FCF가 함께 움직이는지를 보는 편이 낫습니다.
확인한 주요 자료: NVIDIA GB300 NVL72·Blackwell·AI Inference 공식 자료, NVIDIA 실적 발표와 데이터센터 자료.
※ 이 글은 기술과 기업 구조를 이해하기 위한 정보성 분석이며 특정 종목의 매수·매도를 권유하지 않습니다.
'반도체·컴퓨팅' 카테고리의 다른 글
| Meta는 왜 자체 AI 칩을 만들까? MTIA·추천·추론 비용 분석 (0) | 2026.07.12 |
|---|---|
| AMD EPYC는 AI 서버 CPU에서 무엇이 강할까? 코어·메모리·I/O·경쟁 분석 (0) | 2026.07.11 |
| Micron은 HBM 시장에서 무엇이 강할까? HBM4·미국 공급망·AI 메모리 분석 (0) | 2026.07.11 |
| Marvell은 AI 데이터센터 연결에서 무엇이 강할까? (0) | 2026.07.08 |
| HBMHBM은 왜 AI GPU에 필요할까? 대역폭·적층 구조·HBM4 분석 (0) | 2026.07.07 |