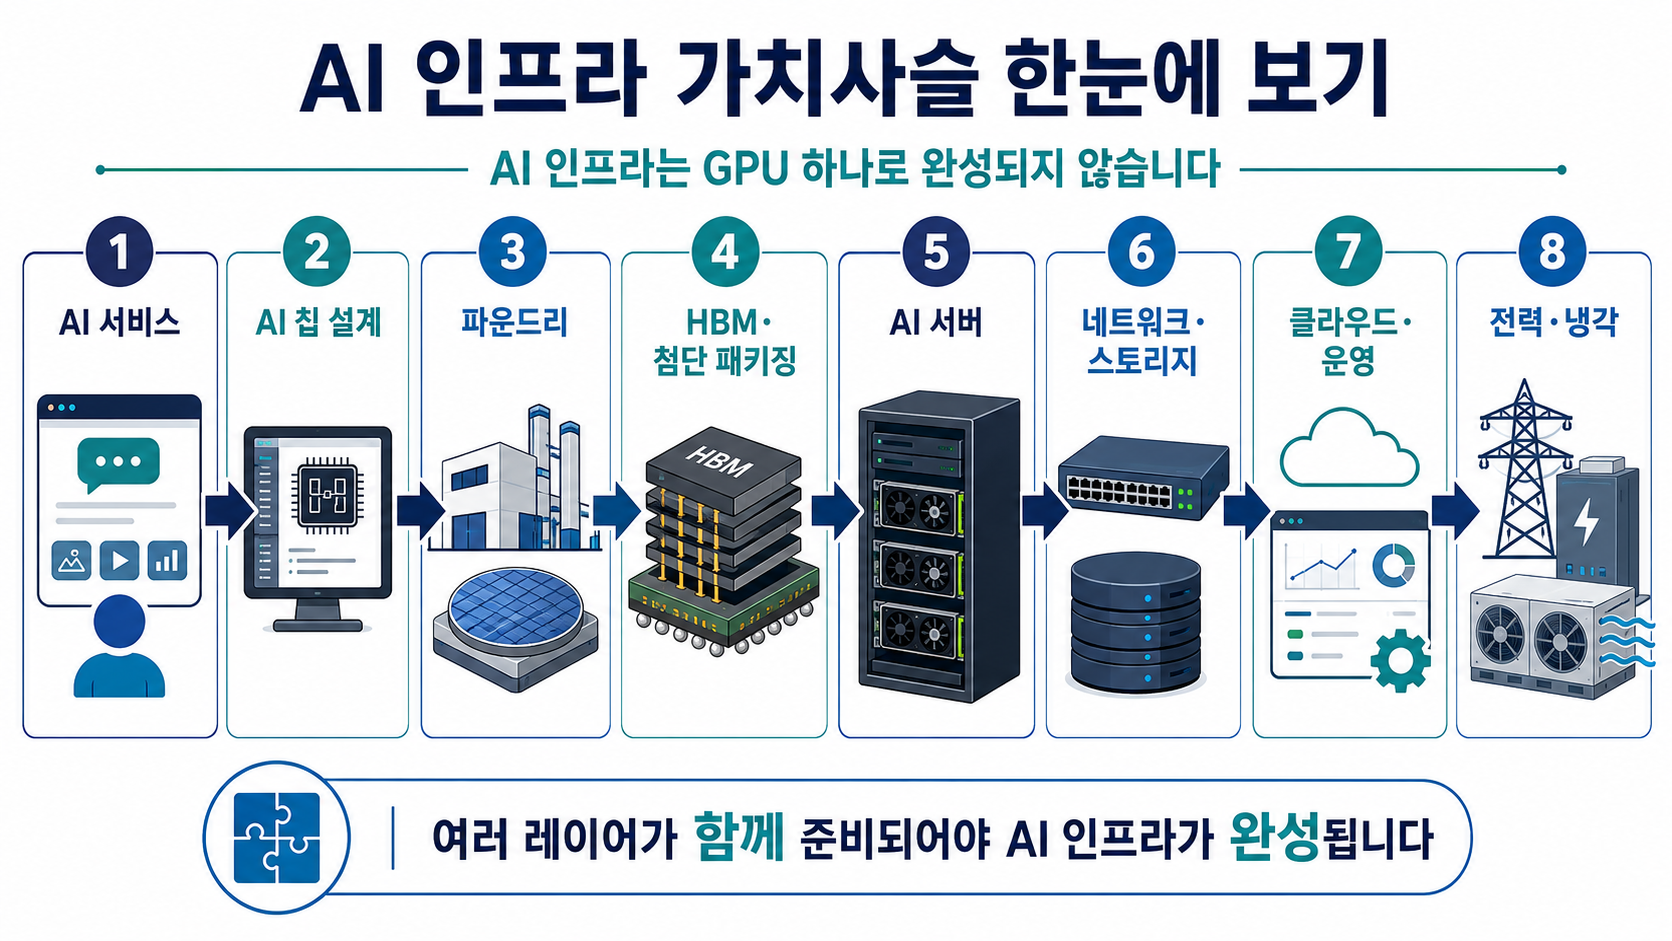
AI 데이터센터를 이해하려면 GPU만 보면 안 됩니다.
칩 설계 → 파운드리 → HBM·패키징 → 서버 → 네트워크·스토리지 → 클라우드 운영 → 전력·냉각이 하나의 체인으로 움직입니다.
이 글은 AI 인프라 세부 글을 연결하는 전체 밸류체인 허브입니다.
AI 인프라는 거대한 공장과 비슷합니다. GPU는 계산 기계, HBM은 바로 옆 작업대, 네트워크는 공장 내부 도로, 스토리지는 창고, 전력과 냉각은 전기와 냉각수입니다. 어느 하나가 부족해도 가장 비싼 GPU가 기다리게 됩니다.
AI 인프라는 가장 비싼 부품 하나가 아니라 현재 가장 부족한 계층이 전체 확장 속도를 결정합니다.
GPU 공급이 늘면 HBM·패키징이, 서버가 늘면 네트워크·전력·냉각·인허가가 다음 병목으로 올라올 수 있습니다.
따라서 AI 밸류체인은 반도체 공급망과 데이터 이동, 데이터센터 운영, 전력·냉각 공급망을 하나의 시스템으로 봐야 합니다.
한 계층의 성능 개선이 다른 계층의 병목을 새로 드러내는 구조입니다.
1. 연산 칩을 만드는 것부터 이미 여러 회사가 필요하다
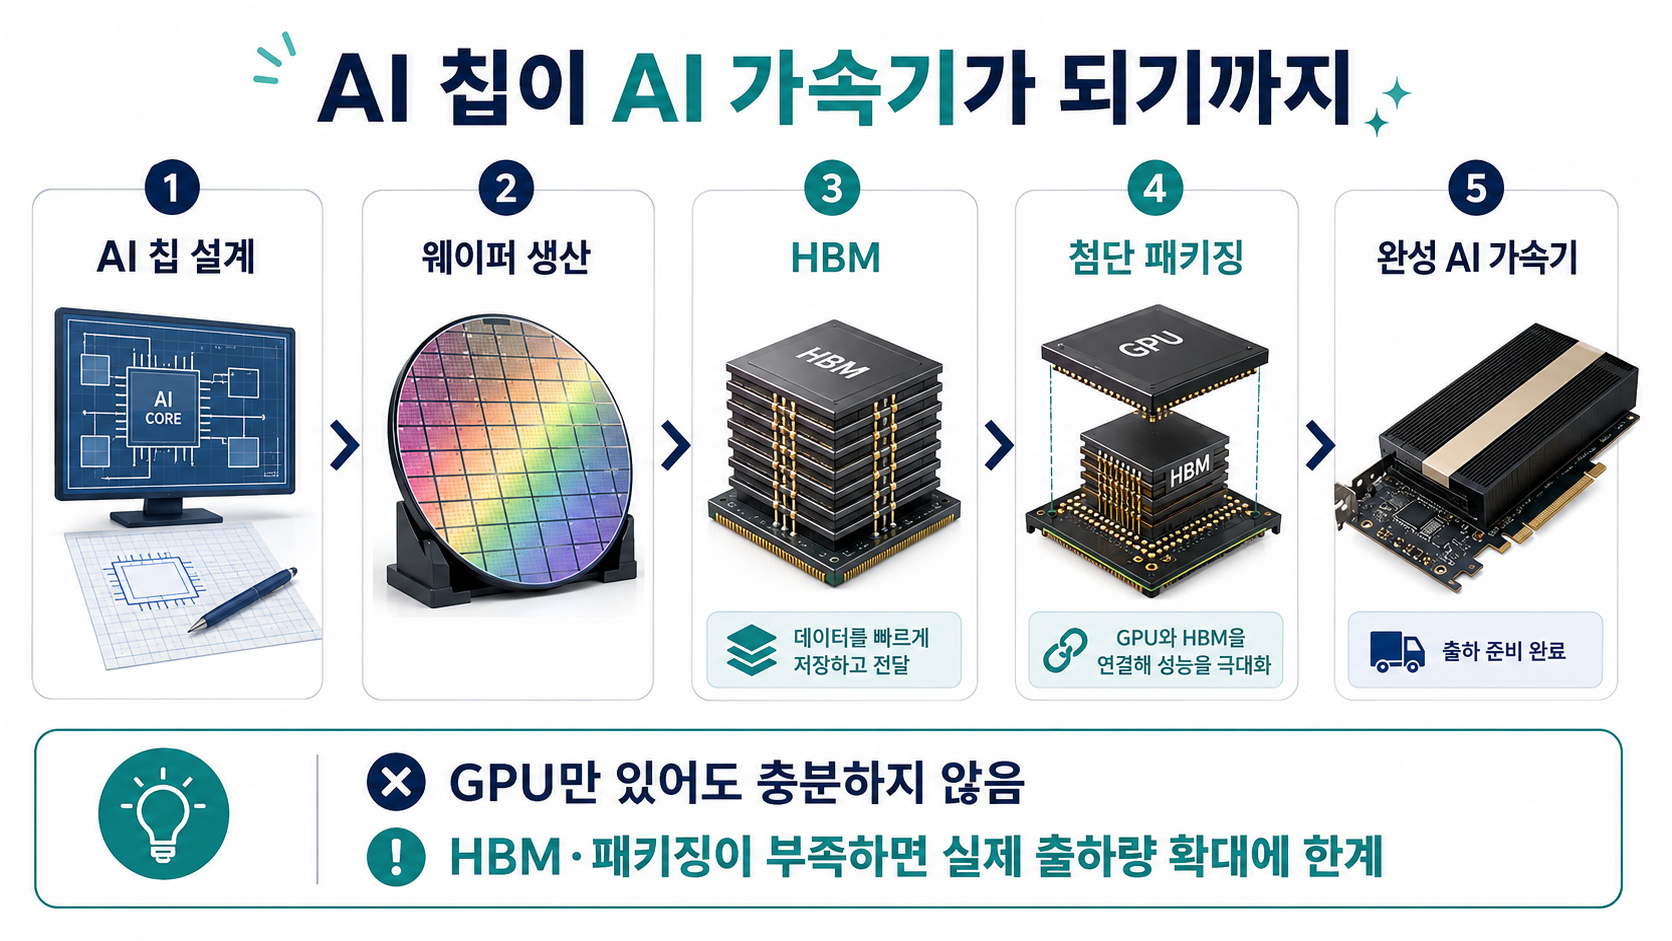
NVIDIA·AMD·Google·Amazon 같은 회사는 GPU나 자체 AI 가속기를 설계하지만, 실제 칩은 파운드리에서 생산됩니다. 여기에 HBM과 첨단 패키징이 붙어야 하나의 고성능 AI 가속기가 완성됩니다.
쉽게 보면 설계 회사가 두뇌를 만들고, 파운드리가 칩을 생산하며, 메모리와 패키징이 데이터를 빠르게 공급하도록 완성하는 구조입니다.
| 계층 | 역할 | 대표 기업 예시 |
|---|---|---|
| AI 가속기 설계 | GPU·TPU·ASIC 구조 설계 | NVIDIA, AMD, Google, Amazon |
| 파운드리 | 최첨단 공정으로 칩 생산 | TSMC, Samsung, Intel |
| HBM | 가속기 가까이에서 대용량 데이터 공급 | SK hynix, Micron, Samsung |
| 첨단 패키징 | 연산칩과 HBM을 고속으로 연결 | TSMC 등 |
2. AI 서버는 GPU를 꽂은 컴퓨터가 아니다
AI 서버 안에는 가속기뿐 아니라 CPU, HBM, NIC, 스위치 연결, 전원부가 함께 들어갑니다.
수십~수백 개 서버를 랙 단위로 묶으면 어느 한 부분의 성능이 부족해도 비싼 GPU가 기다리는 시간이 생깁니다.
그래서 AI 서버의 실제 성능은 가속기 개수보다 전체 시스템이 얼마나 균형 있게 데이터를 공급하고 이동시키는지에 좌우됩니다.
학습 데이터와 체크포인트에는 높은 처리량이 필요하고, 대규모 데이터 보관에는 용량과 비용이 중요합니다. 따라서 NVMe SSD·공유 플래시·오브젝트 스토리지·HDD가 서로 다른 계층을 맡습니다.
3. 네트워크는 수천 개 GPU를 하나의 컴퓨터처럼 묶는다
대규모 AI 학습은 여러 GPU가 계속 데이터를 주고받습니다.
이때 InfiniBand나 Ethernet/RoCE, NIC, 스위치, 광트랜시버가 GPU 사이의 통신 경로가 됩니다.
링크 속도만 빠르다고 끝나는 것이 아니라 지연, 혼잡, 패킷 손실, 집단 통신 효율까지 함께 맞아야 GPU 활용률을 높일 수 있습니다.
| 계층 | 무엇을 해결하나 | 대표 기업 예시 |
|---|---|---|
| 스위치·NIC | GPU 서버 사이 데이터 이동 | NVIDIA, Arista, Cisco, Broadcom |
| 광연결 | 랙·데이터홀 간 고속 연결 | 광모듈·DSP·케이블 업체 |
| 스토리지 | 학습 데이터·체크포인트·아카이브 | NetApp, Pure Storage, Seagate, Western Digital 등 |

4. 클라우드는 부품을 실제 AI 서비스로 바꾸는 계층이다
AWS·Azure·Google Cloud·Oracle 같은 클라우드 업체는 수많은 서버·네트워크·스토리지를 하나의 서비스로 묶습니다. 그 위에 모델 개발 도구, 스케줄러, 보안, 데이터베이스, 에이전트 운영 플랫폼이 올라갑니다.
이 단계부터 중요한 숫자는 칩의 최고 성능보다 GPU 사용률, 토큰당 비용, 서비스 가동률, 고객이 실제로 쓰는 AI 워크로드입니다.
5. 전력과 냉각은 이제 서버보다 먼저 결정해야 한다
AI 랙의 전력 밀도가 높아질수록 데이터센터는 전력망 연결, 변압기, UPS, PDU, 배터리, 냉각 설비를 서버와 동시에 계획해야 합니다.
특히 고밀도 랙은 공랭만으로 처리하기 어려운 구간이 늘면서 콜드플레이트·CDU·열교환기를 이용한 액체냉각 비중이 커지고 있습니다.
전력 쪽에서도 더 높은 랙 밀도를 지원하기 위해 고전압 배전과 새로운 전력 아키텍처가 함께 발전하고 있습니다.
이 변화가 중요한 이유는 GPU를 구매한 시점과 실제 AI 용량이 서비스되는 시점이 다르기 때문입니다.
송전·변전·전력장비의 증설 속도가 서버 설치보다 느리면 GPU가 준비돼도 데이터센터 전체 가동은 늦어질 수 있습니다.
| 계층 | 역할 | 대표 기업 예시 |
|---|---|---|
| 전력·열관리 | UPS·배전·액체냉각·제어 | Vertiv, Eaton, Schneider Electric |
| 데이터센터 시설 | 전력·공간·연결 인프라 제공 | Equinix, Digital Realty 등 |
| 전력 공급 | 발전·송전·변전·ESS | 유틸리티·전력장비·발전 기업 |

6. 이 글을 허브로 볼 때 ‘다음 병목’을 따라가면 된다
AI 인프라에서는 한 병목이 풀리면 다른 계층이 제한 요소로 올라옵니다.
GPU 공급이 좋아져도 HBM·패키징이 부족할 수 있고, 서버가 준비돼도 전력 연결이 늦으면 데이터센터를 켤 수 없습니다.
가속기 공급량 · HBM/패키징 생산능력 · 네트워크와 광연결 · 스토리지 처리량 · 확보 가능한 데이터센터 전력 · 랙 전력밀도 · 액체냉각 채택 · GPU 활용률을 서로 분리해서 봐야 합니다.
세부 글은 크게
① 칩·메모리·패키징
② 서버·네트워크·스토리지
③ 클라우드·데이터센터 운영
④ 전력·냉각·ESS·발전 네 묶음으로 따라가면 이해하기 쉽습니다.
이 허브에서 각 기술과 기업 글을 해당 계층으로 연결하면 독자도 전체 구조를 놓치지 않고 세부 주제로 이동할 수 있습니다.
따라서 이 산업에서는 “AI가 성장한다”는 한 문장보다 현재 부족한 계층이 어디인지, 그 부족이 얼마나 오래 지속되는지, 공급 확대 후에도 마진이 유지되는지가 더 중요합니다.
병목은 영원하지 않습니다. 공급사가 CAPEX를 크게 늘리면 몇 년 뒤 과잉 공급으로 바뀔 수 있습니다. 그래서 수요 성장과 함께 생산능력 증가 속도도 같이 봐야 합니다.
AI 인프라는 GPU 산업 하나가 아니라 반도체·메모리·패키징·서버·네트워크·스토리지·클라우드·전력·냉각이 연결된 시스템 산업입니다.
한 계층의 공급이 늘면 병목은 다른 곳으로 이동합니다.
그래서 이 전체 지도를 먼저 이해한 뒤 각 회사와 기술을 ‘어느 계층의 어떤 병목을 해결하는가’라는 질문으로 읽는 것이 가장 쉽습니다.
'클라우드·데이터센터' 카테고리의 다른 글
| Eaton은 AI 데이터센터 전력에서 왜 중요할까? UPS·배전·800VDC 분석 (0) | 2026.08.31 |
|---|---|
| Digital Realty는 AI 데이터센터 수요를 얼마나 흡수할 수 있을까 (0) | 2026.08.20 |
| AI 시대에도 HDD가 필요한 이유: 44TB HAMR과 데이터센터 스토리지 전략 (0) | 2026.08.19 |
| 액체냉각은 AI 서버의 필수가 될까? (0) | 2026.07.20 |
| NetApp은 AI 데이터 관리 시대에 다시 주목받을 수 있을까? 스토리지 기업의 새로운 기회와 한계 (1) | 2026.07.19 |