GPU 3

AI 인프라 밸류체인은 어떻게 연결될까? GPU·HBM·네트워크·전력·냉각 쉽게 보기

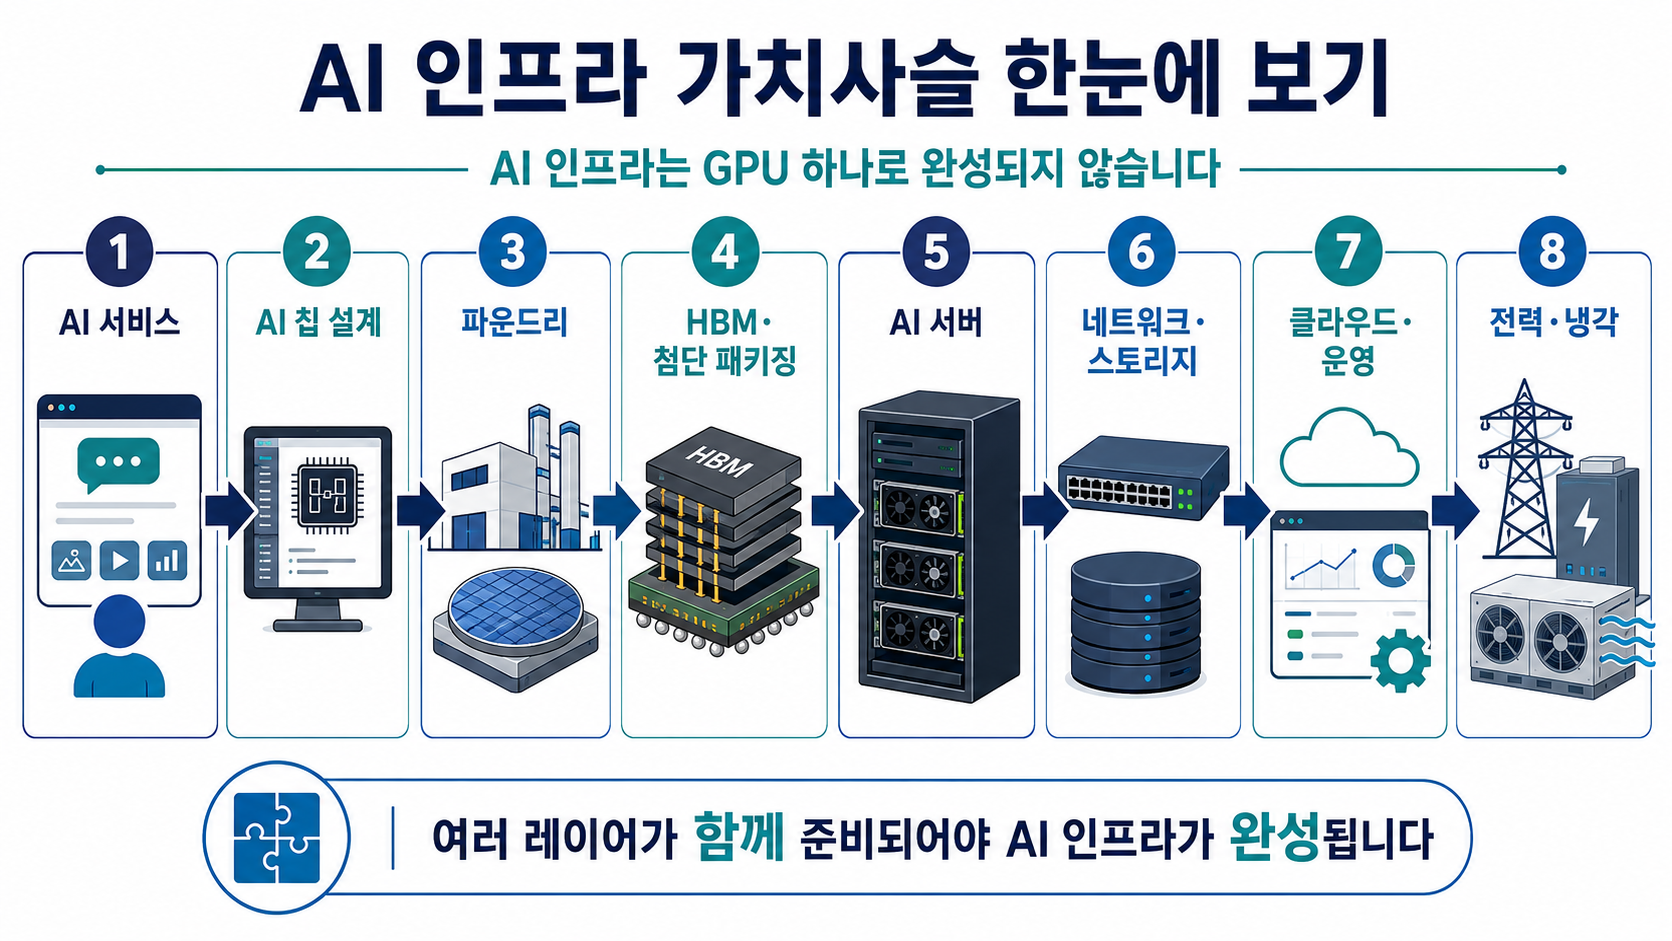
AI 데이터센터를 이해하려면 GPU만 보면 안 됩니다.칩 설계 → 파운드리 → HBM·패키징 → 서버 → 네트워크·스토리지 → 클라우드 운영 → 전력·냉각이 하나의 체인으로 움직입니다.이 글은 AI 인프라 세부 글을 연결하는 전체 밸류체인 허브입니다.초보자라면 이것만 먼저AI 인프라는 거대한 공장과 비슷합니다. GPU는 계산 기계, HBM은 바로 옆 작업대, 네트워크는 공장 내부 도로, 스토리지는 창고, 전력과 냉각은 전기와 냉각수입니다. 어느 하나가 부족해도 가장 비싼 GPU가 기다리게 됩니다.핵심 요약AI 인프라는 가장 비싼 부품 하나가 아니라 현재 가장 부족한 계층이 전체 확장 속도를 결정합니다.GPU 공급이 늘면 HBM·패키징이, 서버가 늘면 네트워크·전력·냉각·인허가가 다음 병목으로 올라올 수 ..
구글 클라우드는 TPU로 차별화할 수 있을까?

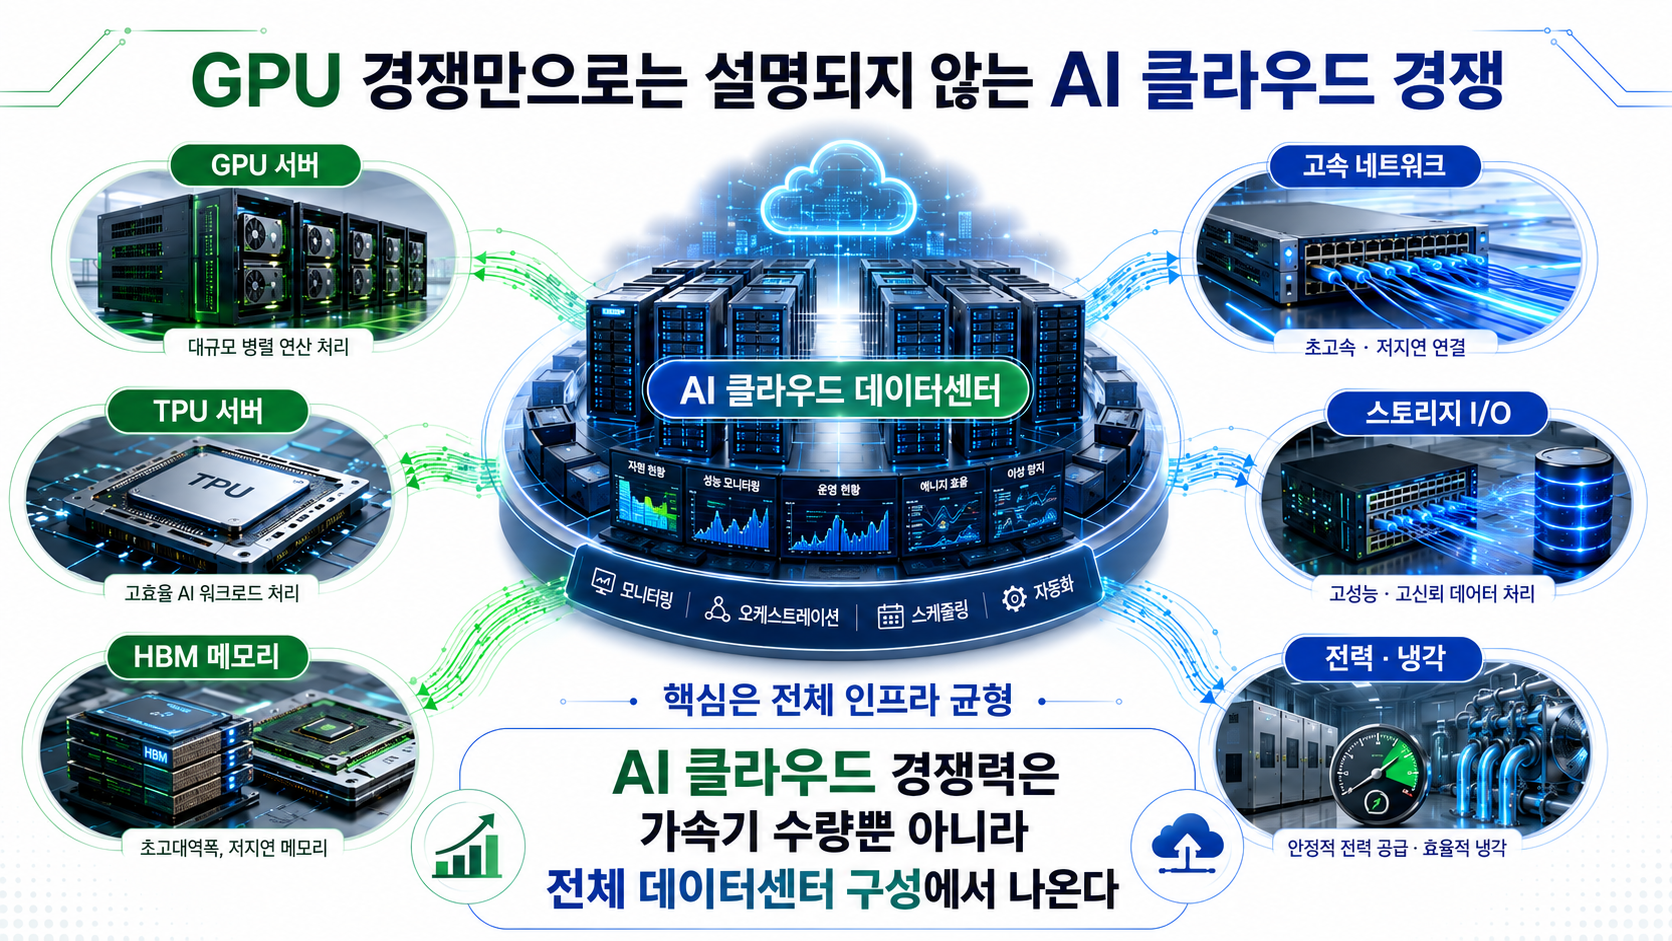
AI 클라우드 시장을 보면 가장 먼저 떠오르는 것은 GPU입니다. 대형 언어 모델을 학습하고, 이미지를 생성하고, 수많은 사용자의 요청을 처리하려면 강력한 AI 가속기가 필요하기 때문입니다. 그래서 많은 기업이 엔비디아 GPU 확보 경쟁에 집중합니다. 하지만 클라우드 사업자의 경쟁력은 GPU를 얼마나 많이 확보했는지만으로 정리되지 않습니다. 데이터센터 구성에서는 연산 칩, 메모리, 네트워크, 스토리지, 전력, 냉각, 소프트웨어 운영 체계가 함께 맞아야 합니다. 이런 관점에서 구글 클라우드가 내세울 수 있는 가장 큰 차별점 중 하나가 바로 TPU입니다. TPU는 구글이 AI 연산을 위해 직접 설계해 온 전용 가속기입니다. 구글 검색, 번역, 유튜브, 지메일, Gemini 같은 대규모 서비스 운영 경험이 반..

AI·소프트웨어 2026.07.07

HBMHBM은 왜 AI GPU에 필요할까? 대역폭·적층 구조·HBM4 분석

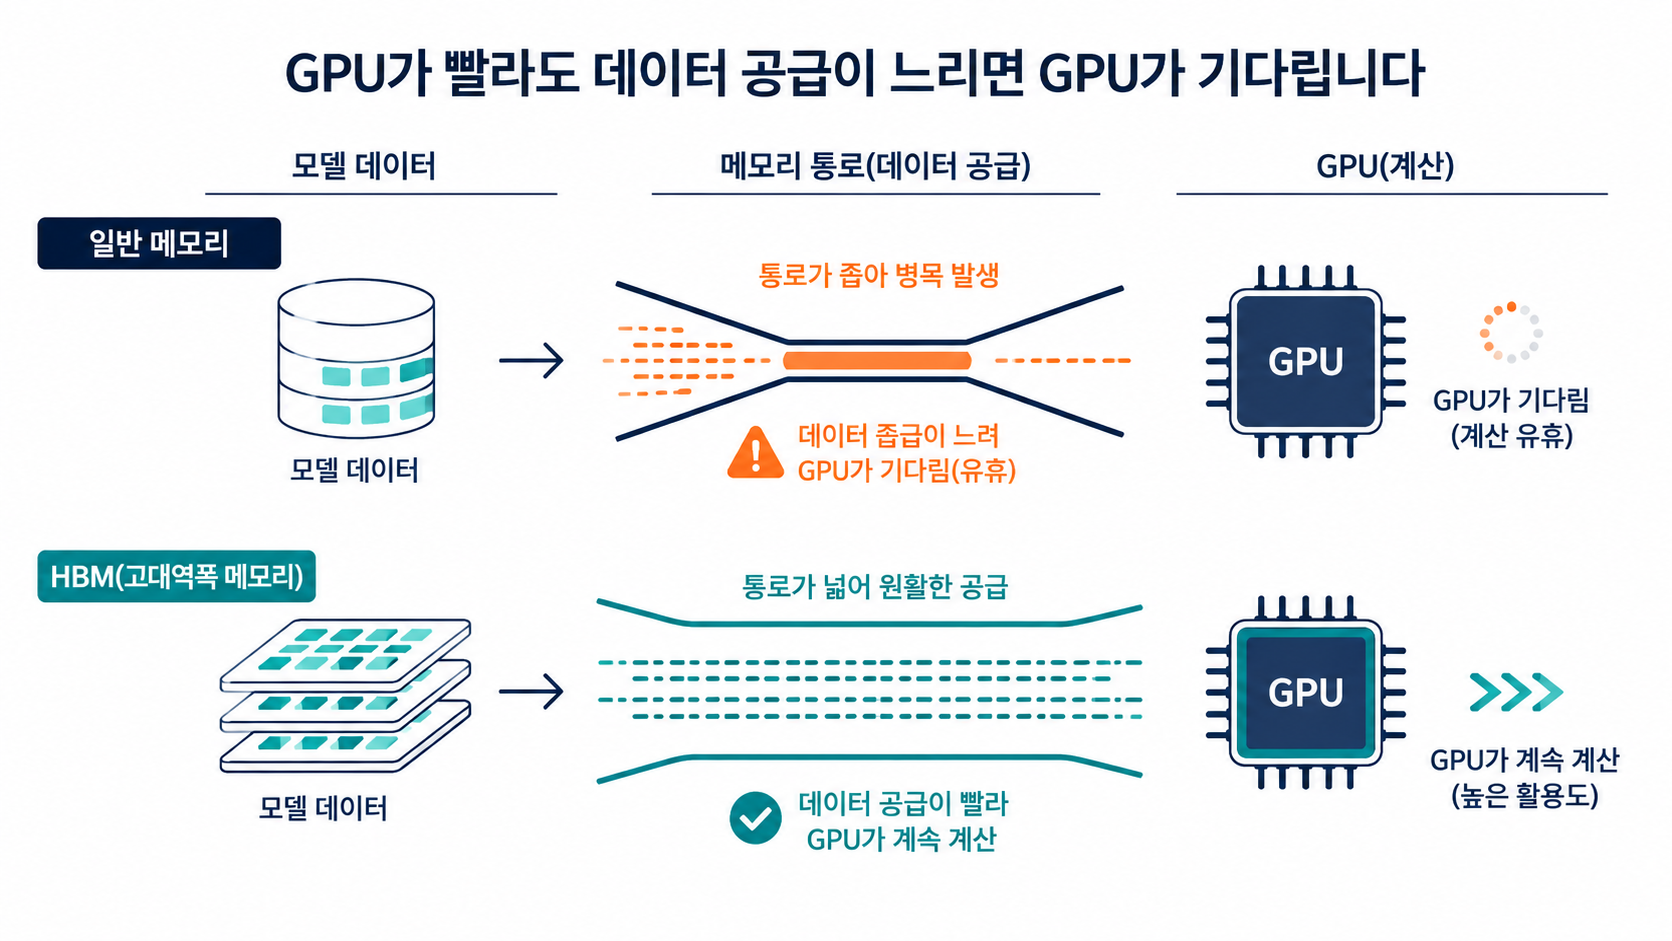
AI GPU는 계산 능력만 높다고 성능이 나오는 것이 아닙니다.필요한 데이터를 메모리가 제때 공급하지 못하면 GPU 코어가 기다리게 됩니다.HBM은 여러 DRAM을 수직으로 쌓아 GPU 가까이 배치하고 매우 넓은 통로로 연결한 고대역폭 메모리입니다.먼저 볼 포인트GPU가 계산 작업자라면 HBM은 바로 옆의 초고속 작업대입니다.용량은 한 번에 얼마나 많이 담는지, 대역폭은 1초에 얼마나 많이 옮기는지를 뜻합니다.AI에서는 둘 다 중요합니다.투자 관점에서는 HBM 세대 이름보다 고객 인증, 수율, 실제 출하, 가격·마진, 고급 패키징 용량과 증설 이후 FCF가 더 중요합니다. 1. GPU가 빨라질수록 왜 HBM이 더 중요해질까대형 언어모델은 학습과 추론 과정에서 모델 가중치, 활성값, 어텐션 데이터와 KV ..