AI 클라우드 시장을 보면 가장 먼저 떠오르는 것은 GPU입니다.
대형 언어 모델을 학습하고, 이미지를 생성하고, 수많은 사용자의 요청을 처리하려면 강력한 AI 가속기가 필요하기 때문입니다.
그래서 많은 기업이 엔비디아 GPU 확보 경쟁에 집중합니다.
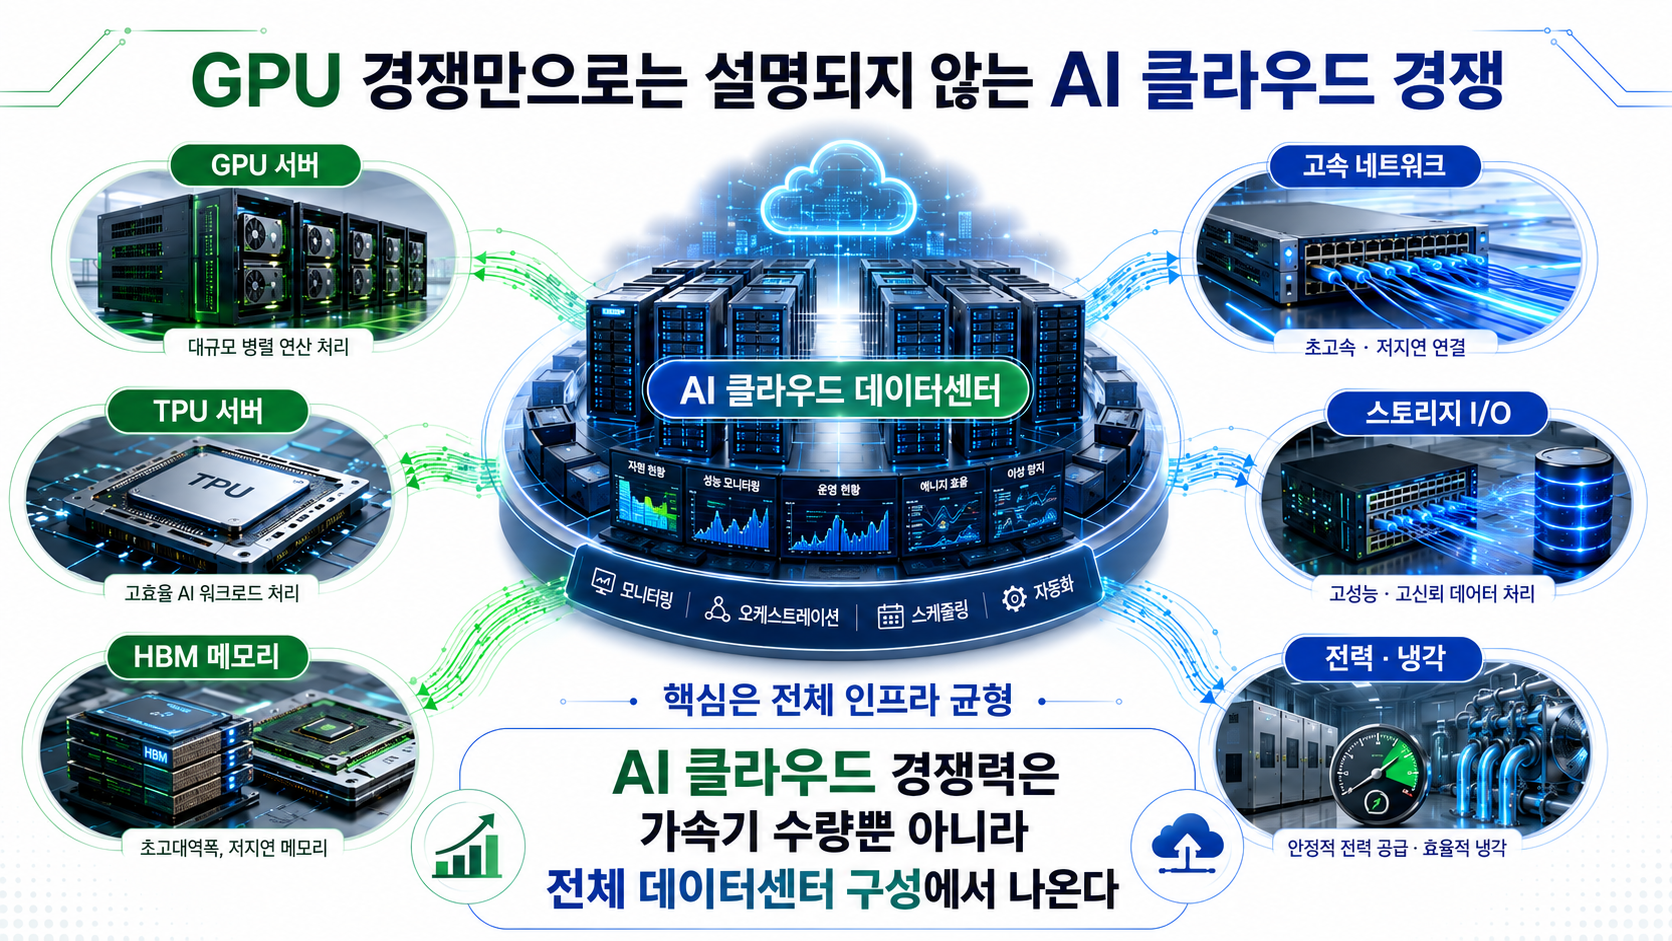
하지만 클라우드 사업자의 경쟁력은 GPU를 얼마나 많이 확보했는지만으로 정리되지 않습니다.
데이터센터 구성에서는 연산 칩, 메모리, 네트워크, 스토리지, 전력, 냉각, 소프트웨어 운영 체계가 함께 맞아야 합니다.
이런 관점에서 구글 클라우드가 내세울 수 있는 가장 큰 차별점 중 하나가 바로 TPU입니다.
TPU는 구글이 AI 연산을 위해 직접 설계해 온 전용 가속기입니다.
구글 검색, 번역, 유튜브, 지메일, Gemini 같은 대규모 서비스 운영 경험이 반영된 칩이라는 점에서 일반 GPU와는 출발점이 조금 다릅니다.
그렇다면 구글 클라우드는 TPU를 통해 AWS, Microsoft Azure, 엔비디아 GPU 중심 생태계와 다른 길을 만들 수 있을까요?
GPU 경쟁만으로는 설명되지 않는 AI 클라우드 경쟁
AI 인프라 구축에서는 GPU가 핵심 장비처럼 보입니다.
실제로 많은 AI 학습과 추론 환경은 GPU 서버, 고속 네트워크, 고성능 스토리지, 대규모 전력 설비를 중심으로 설계됩니다.
하지만 클라우드 사업자의 입장에서는 GPU만 많이 들여오는 것으로 끝나지 않습니다.
대형 AI 모델은 연산량뿐 아니라 데이터 이동량이 매우 큽니다.
GPU나 TPU 같은 가속기가 빠르게 계산하려면 모델 파라미터, 학습 데이터, 중간 결과, KV 캐시 같은 데이터가 끊기지 않고 공급되어야 합니다.
이 과정에서 HBM 대역폭, 서버 내부 PCIe 연결, 가속기 간 통신, 데이터센터 네트워크, 스토리지 I/O가 모두 영향을 줍니다.
구글 클라우드의 TPU 전략은 GPU를 대체한다기보다, AI 워크로드를 구글 클라우드 안에서 더 효율적으로 돌릴 수 있는 선택지를 만드는 방향에 가깝습니다.
특히 구글은 자체 AI 서비스에서 오랫동안 TPU를 사용해 왔고, 이 경험을 클라우드 상품으로 연결하려는 흐름을 보여주고 있습니다.
TPU는 GPU와 무엇이 다를까?
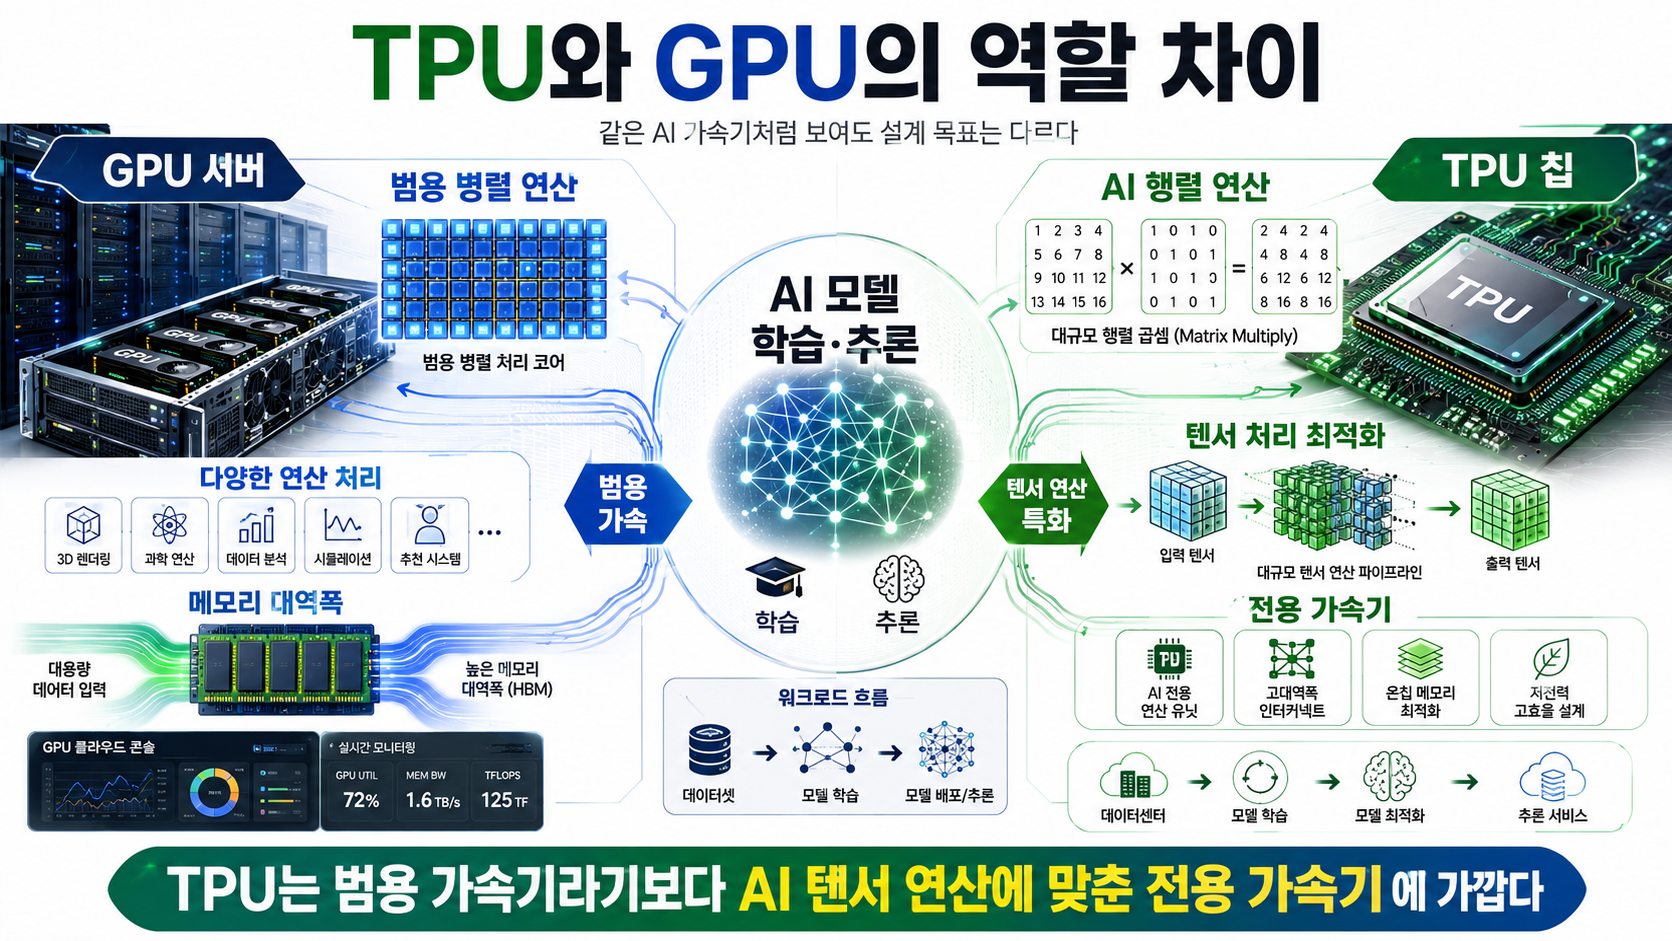
GPU는 원래 그래픽 연산을 위해 발전했지만, 병렬 연산 능력이 뛰어나 AI 학습과 추론에 널리 사용되고 있습니다.
반면 TPU는 처음부터 머신러닝 연산을 효율적으로 처리하기 위해 설계된 전용 ASIC입니다.
여기서 ASIC은 특정 목적에 맞춰 설계한 반도체라는 뜻입니다.
AI 모델에서는 행렬 곱셈과 텐서 연산이 많이 반복됩니다.
TPU는 이런 연산을 빠르고 효율적으로 처리하는 데 초점을 둡니다.
그래서 범용성이 넓은 GPU와 달리, 특정 AI 워크로드에서는 전력 대비 성능이나 비용 효율 측면에서 장점을 만들 수 있습니다.
다만 이 차이는 “GPU가 좋다” 또는 “TPU가 좋다”로 단순히 나눌 문제는 아닙니다.
실제 서버 운영에서는 어떤 프레임워크를 쓰는지, 모델이 어떤 구조인지, 학습인지 추론인지, 개발팀이 JAX나 PyTorch/XLA 환경에 익숙한지에 따라 선택이 달라질 수 있습니다.
TPU는 잘 맞는 환경에서는 강한 효율을 보여줄 수 있지만, 기존 GPU 기반 코드와 운영 체계가 깊게 자리 잡은 조직에서는 전환 비용도 함께 봐야 합니다.
구글 클라우드의 강점은 칩 하나가 아니라 전체 스택
구글 클라우드가 TPU로 차별화하려면 칩 성능만 앞세워서는 부족합니다.
AI 인프라는 가속기만 빠르다고 좋은 결과가 나오는 구조가 아니기 때문입니다.
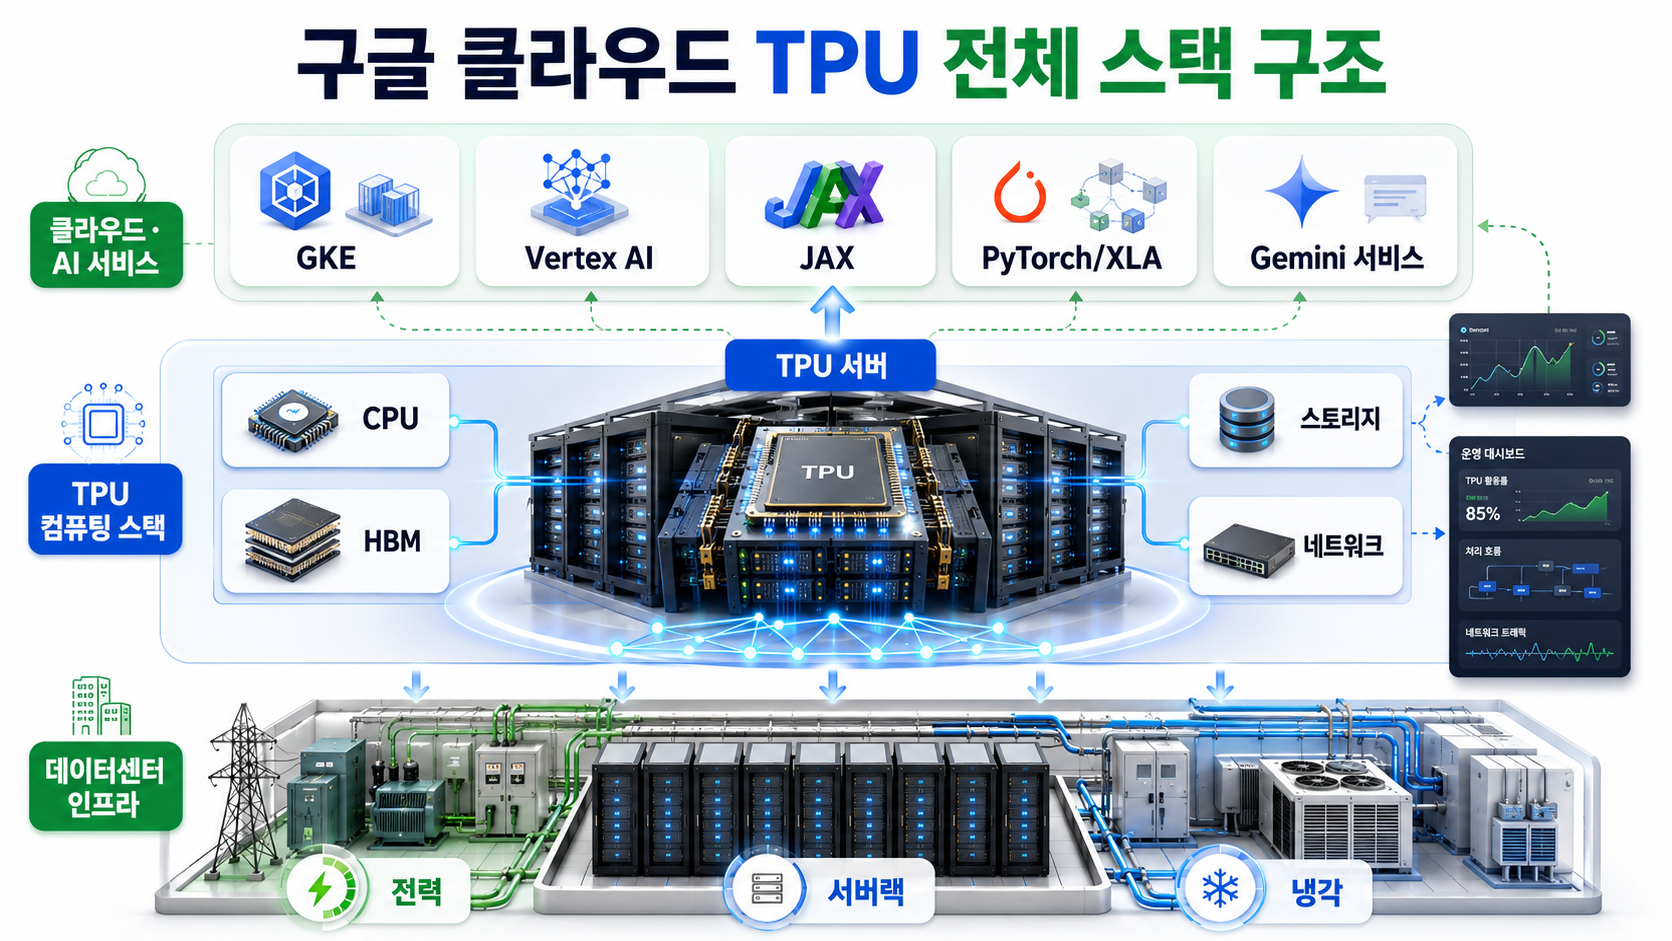
TPU가 의미를 가지려면 CPU, 메모리, 네트워크, 스토리지, 컨테이너 플랫폼, AI 프레임워크가 함께 움직여야 합니다.
구글은 TPU를 Google Kubernetes Engine, Compute Engine, Cloud Storage, Hyperdisk, Vertex AI, JAX, PyTorch/XLA 같은 환경과 연결합니다.
이 구조는 사용자가 직접 서버를 사고, 랙에 장착하고, 네트워크를 구성하고, 드라이버와 라이브러리를 맞추는 방식과는 다릅니다. 클라우드 안에서 AI 학습과 추론을 빠르게 구성할 수 있게 만드는 것이 핵심입니다.
TPU의 차별화 포인트는 단순히 칩 성능이 아니라, 칩·네트워크·스토리지·프레임워크·운영 플랫폼을 한 덩어리로 묶는 데 있습니다. 이 부분은 자체 데이터센터와 클라우드 플랫폼을 모두 가진 구글의 장점이 될 수 있습니다.
특히 구글은 대규모 AI 모델을 직접 운영하는 회사입니다.
검색, 광고, 유튜브, 안드로이드, Workspace, Gemini 같은 서비스에서 발생하는 AI 요구사항을 내부에서 계속 경험합니다.
이 경험이 TPU 세대 개선과 클라우드 상품 설계에 반영될 수 있다는 점은 다른 단순 칩 공급 방식과 다른 부분입니다.
Ironwood와 Trillium이 보여주는 방향
최근 TPU 흐름에서 눈에 띄는 이름은 Trillium과 Ironwood입니다.
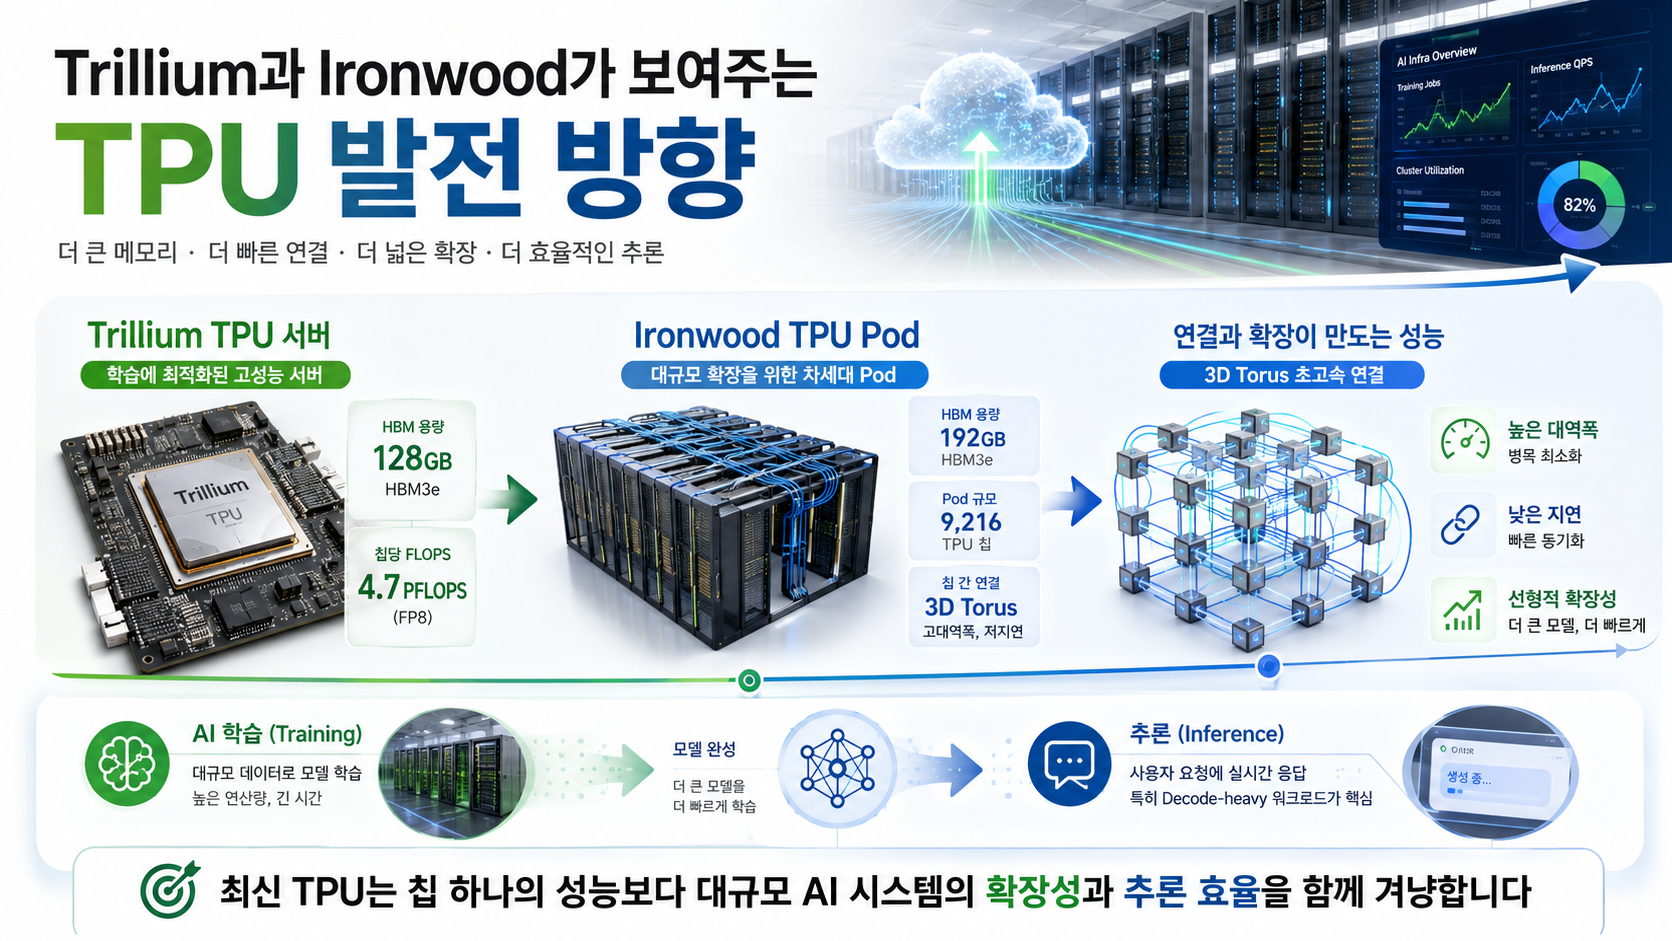
Trillium은 TPU v6e로 불리며, Google Cloud 문서에서는 Transformer, text-to-image, CNN 학습, 파인튜닝, 서빙에 맞춘 세대로 설명합니다.
Ironwood는 TPU7x로 제공되며, 대규모 dense 모델과 MoE 모델, 사전 학습, 샘플링, decode-heavy 추론까지 겨냥합니다.
데이터센터 구성에서는 이 변화가 중요합니다.
AI 모델이 커질수록 단순 연산 성능만이 아니라 HBM 용량, HBM 대역폭, 가속기 간 연결, Pod 단위 확장성이 중요해집니다. Ironwood는 칩당 큰 HBM 용량과 높은 HBM 대역폭, 대규모 Pod 구성을 강조합니다.
이는 AI 서버 한 대의 성능보다 여러 가속기를 묶어 하나의 거대한 AI 시스템처럼 쓰는 방향에 가깝습니다.
또 하나 봐야 할 부분은 추론입니다.
AI 서비스가 실제 사용자에게 제공되기 시작하면 학습보다 추론 비용이 더 크게 느껴질 수 있습니다.
챗봇, 검색 요약, 코딩 보조, 이미지 생성, 업무 자동화처럼 사용자가 많아질수록 요청을 빠르게 처리해야 합니다.
TPU가 추론 효율에서 장점을 만든다면 구글 클라우드는 AI 서비스 운영 비용 측면에서 차별화할 여지가 있습니다.
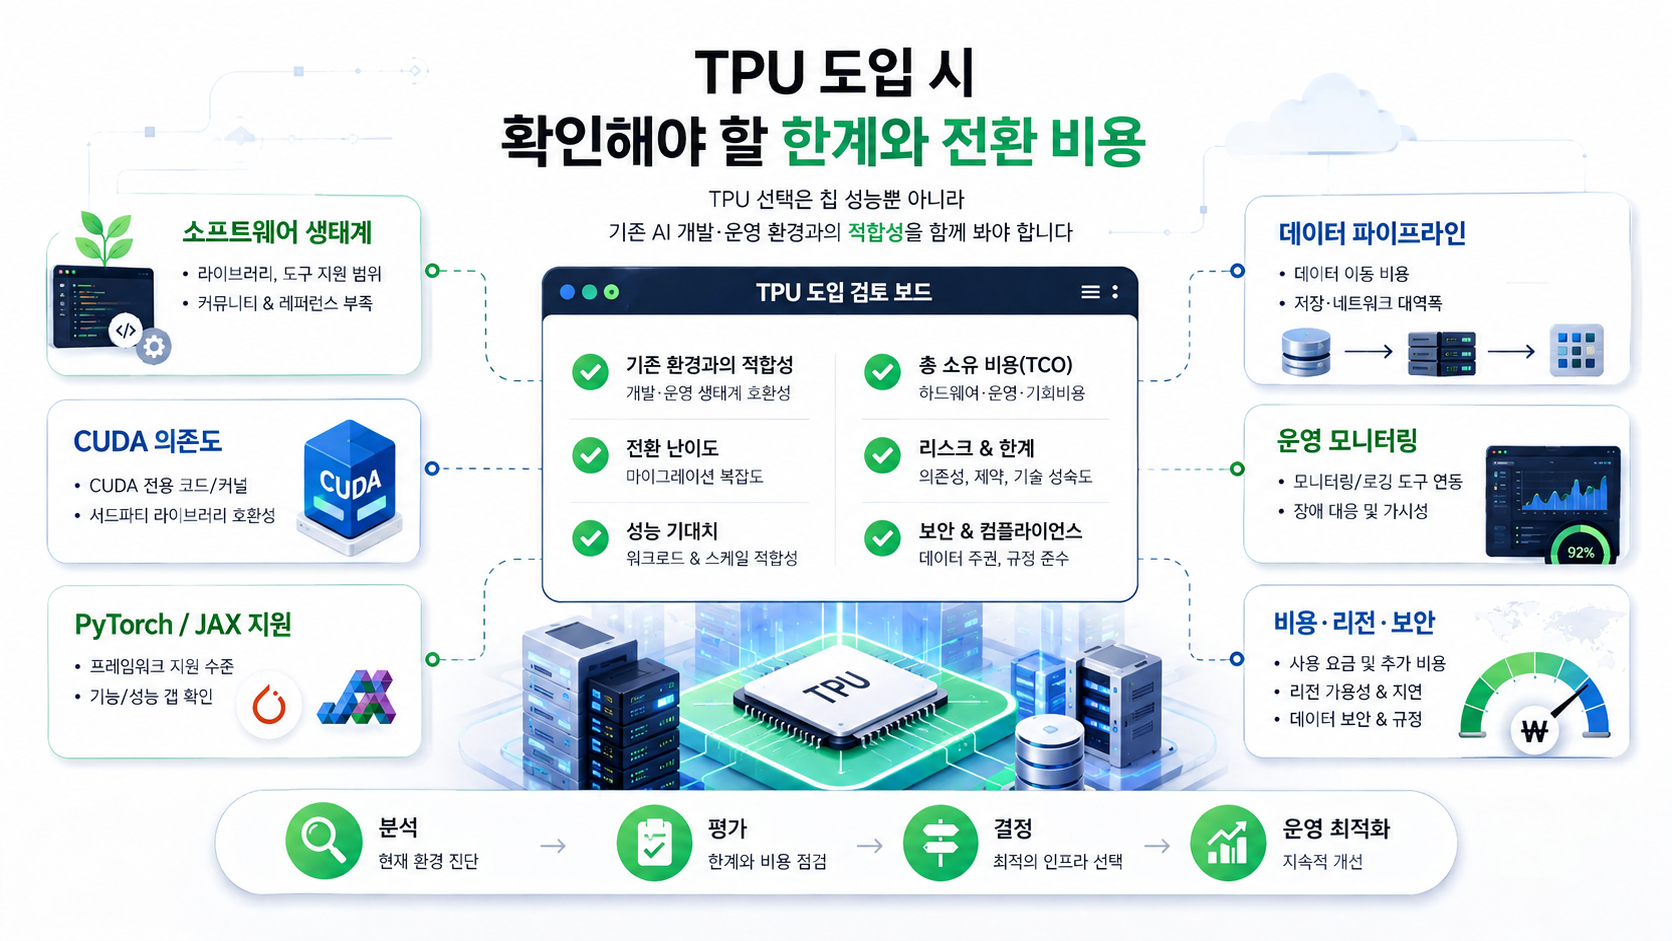
차별화의 한계는 생태계와 전환 비용에 있다
TPU가 기술적으로 매력적이라고 해도, 구글 클라우드가 곧바로 AI 인프라 시장을 쉽게 가져간다고 보기는 어렵습니다.
가장 큰 이유는 소프트웨어 생태계입니다.
AI 개발자와 기업 고객 상당수는 CUDA, 엔비디아 GPU, PyTorch 기반 환경에 익숙합니다.
이미 운영 중인 모델, 학습 스크립트, 모니터링, 배포 파이프라인도 GPU 중심으로 구성된 경우가 많습니다.
TPU를 쓰려면 모델 구조와 프레임워크 지원, 컴파일 방식, 분산 학습 설정, 데이터 입력 파이프라인을 다시 확인해야 합니다.
작은 테스트에서는 잘 동작해도 대규모 학습이나 서비스 배포 단계에서는 예상하지 못한 튜닝이 필요할 수 있습니다.
또한 클라우드 고객은 특정 칩 하나만 보고 플랫폼을 고르지 않습니다.
가격, 리전, 네트워크 품질, 보안, 운영 도구, 기존 시스템과의 연동, 멀티클라우드 전략까지 함께 봅니다.
TPU가 좋더라도 고객이 이미 AWS나 Azure, 온프레미스 GPU 클러스터에 많은 투자를 했다면 선택은 복잡해집니다.
그래서 TPU는 구글 클라우드의 강력한 차별화 요소가 될 수 있지만, 모든 고객에게 같은 수준의 장점으로 작동한다고 보기는 어렵습니다. 도입 시 확인할 부분은 모델 적합성, 개발팀 역량, 운영 자동화, 비용 구조, 장기적인 클라우드 전략입니다.
앞으로 볼 포인트는 추론, 네트워크, 비용 효율
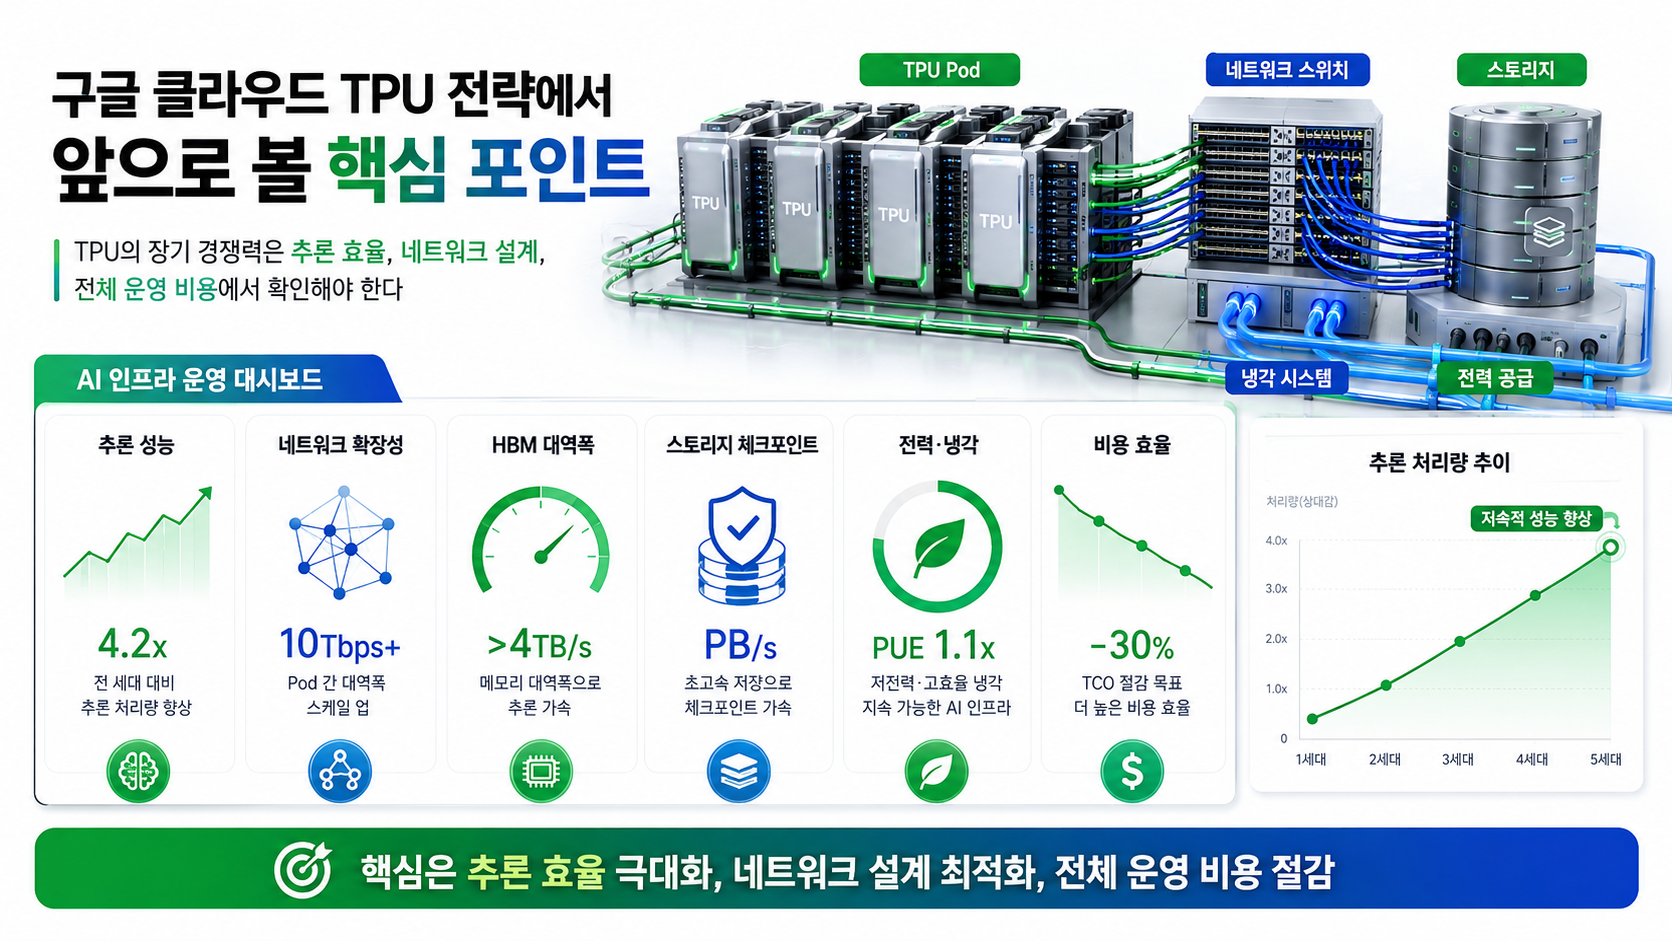
앞으로 구글 클라우드의 TPU 전략을 볼 때는 세 가지를 함께 봐야 합니다.
첫째는 추론입니다.
AI 모델을 학습하는 것도 중요하지만, 실제 수익과 운영 비용은 사용자가 계속 요청을 보내는 추론 환경에서 크게 드러날 수 있습니다. TPU가 낮은 지연 시간과 높은 처리량을 안정적으로 제공한다면 구글 클라우드의 차별화는 더 선명해질 수 있습니다.
둘째는 네트워크입니다.
대규모 AI 인프라에서는 가속기 간 통신이 성능을 좌우합니다.
모델 병렬 처리, 데이터 병렬 처리, All-reduce, 체크포인트 저장, 분산 추론 과정에서 네트워크 병목이 생기면 좋은 칩도 충분히 활용하기 어렵습니다.
TPU Pod, 고속 인터커넥트, 데이터센터 네트워크 설계가 함께 중요해지는 이유입니다.
셋째는 비용 효율입니다.
AI 서비스가 많아질수록 기업은 성능만 보는 것이 아니라 같은 비용으로 얼마나 많은 요청을 처리할 수 있는지를 봅니다.
서버 구성에서 중요한 부분은 칩 가격만이 아니라 전력, 냉각, 운영 인력, 장애 대응, 소프트웨어 최적화까지 포함한 전체 비용입니다.
결국 TPU가 구글 클라우드의 차별화 무기가 되려면, “좋은 칩”을 넘어 “운영하기 좋은 AI 인프라”라는 평가를 받아야 합니다.
마무리
구글 클라우드는 TPU를 통해 AI 클라우드 시장에서 분명한 차별화 포인트를 만들고 있습니다.
TPU는 구글이 직접 설계한 AI 가속기이고, 구글 내부 서비스와 클라우드 플랫폼 경험이 함께 반영된 인프라 전략입니다.
하지만 TPU만으로 모든 경쟁이 끝나는 것은 아닙니다.
AI 인프라 구축에서는 GPU 생태계, 개발자 도구, 모델 호환성, 네트워크, 스토리지, 전력·냉각, 비용 구조를 함께 봐야 합니다.
TPU는 구글 클라우드가 “남들과 다른 AI 인프라 선택지”를 제시하는 핵심 도구가 될 수 있지만, 고객 입장에서는 워크로드에 맞는지 검증하는 과정이 필요합니다.
정리하면 구글 클라우드의 TPU 차별화는 충분히 가능성이 있습니다.
다만 그 힘은 칩 하나에서만 나오는 것이 아니라, TPU를 둘러싼 데이터센터 설계, 클라우드 운영 플랫폼, AI 소프트웨어 생태계가 함께 맞을 때 더 크게 드러날 수 있습니다.
'AI·소프트웨어' 카테고리의 다른 글
| Big Tech AI 투자 약 7300억달러, 결국 누가 돈을 벌까? 엔비디아·클라우드·전력 수혜주 (0) | 2026.09.08 |
|---|---|
| Meta는 AI 투자로 어떻게 돈을 벌까? 광고·데이터센터 CAPEX·FCF 구조 (0) | 2026.08.30 |
| 구글은 Gemini와 TPU를 어떻게 연결하고 있을까? AI 인프라 관점에서 보기 (0) | 2026.07.27 |
| Oracle OCI는 AI 클라우드에서 왜 강해졌을까? GPU·RDMA·데이터베이스 분석 (0) | 2026.07.11 |
| Supermicro는 AI 서버 시장에서 왜 강할까? 랙스케일·액체냉각·마진 구조 분석 (0) | 2026.07.10 |