Google은 Gemini와 TPU를 왜 함께 만들까? 모델·칩 공동설계 분석
Gemini는 Google의 AI 모델이고, TPU는 그 AI를 학습하고 실행하는 데 쓰는 Google의 자체 AI 가속기입니다.
두 기술을 따로 보기보다 AI 모델과 그 모델을 돌리는 컴퓨터를 함께 설계하는 전략으로 이해하면 Google AI의 강점이 더 잘 보입니다.
Gemini를 ‘AI 프로그램’, TPU를 ‘그 프로그램에 맞춰 만든 전용 엔진’이라고 생각하면 쉽습니다.
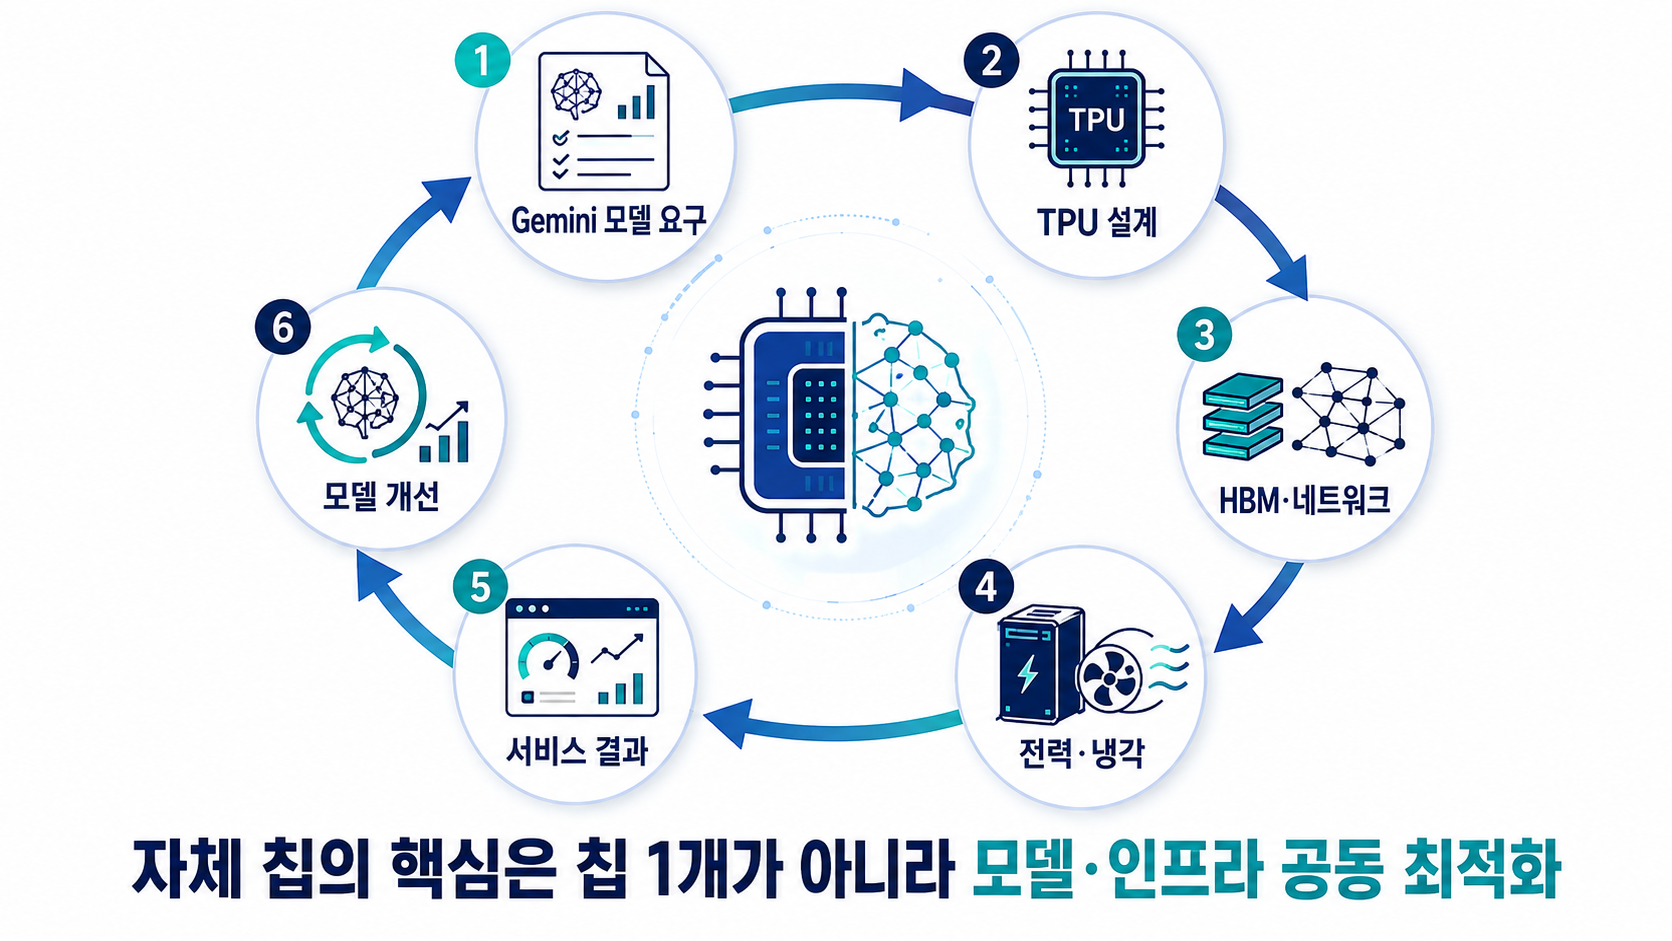
Google은 AI가 어떤 계산과 메모리를 많이 쓰는지 직접 알기 때문에 모델·칩·네트워크·소프트웨어를 함께 바꿔 비용과 속도를 최적화할 수 있습니다.
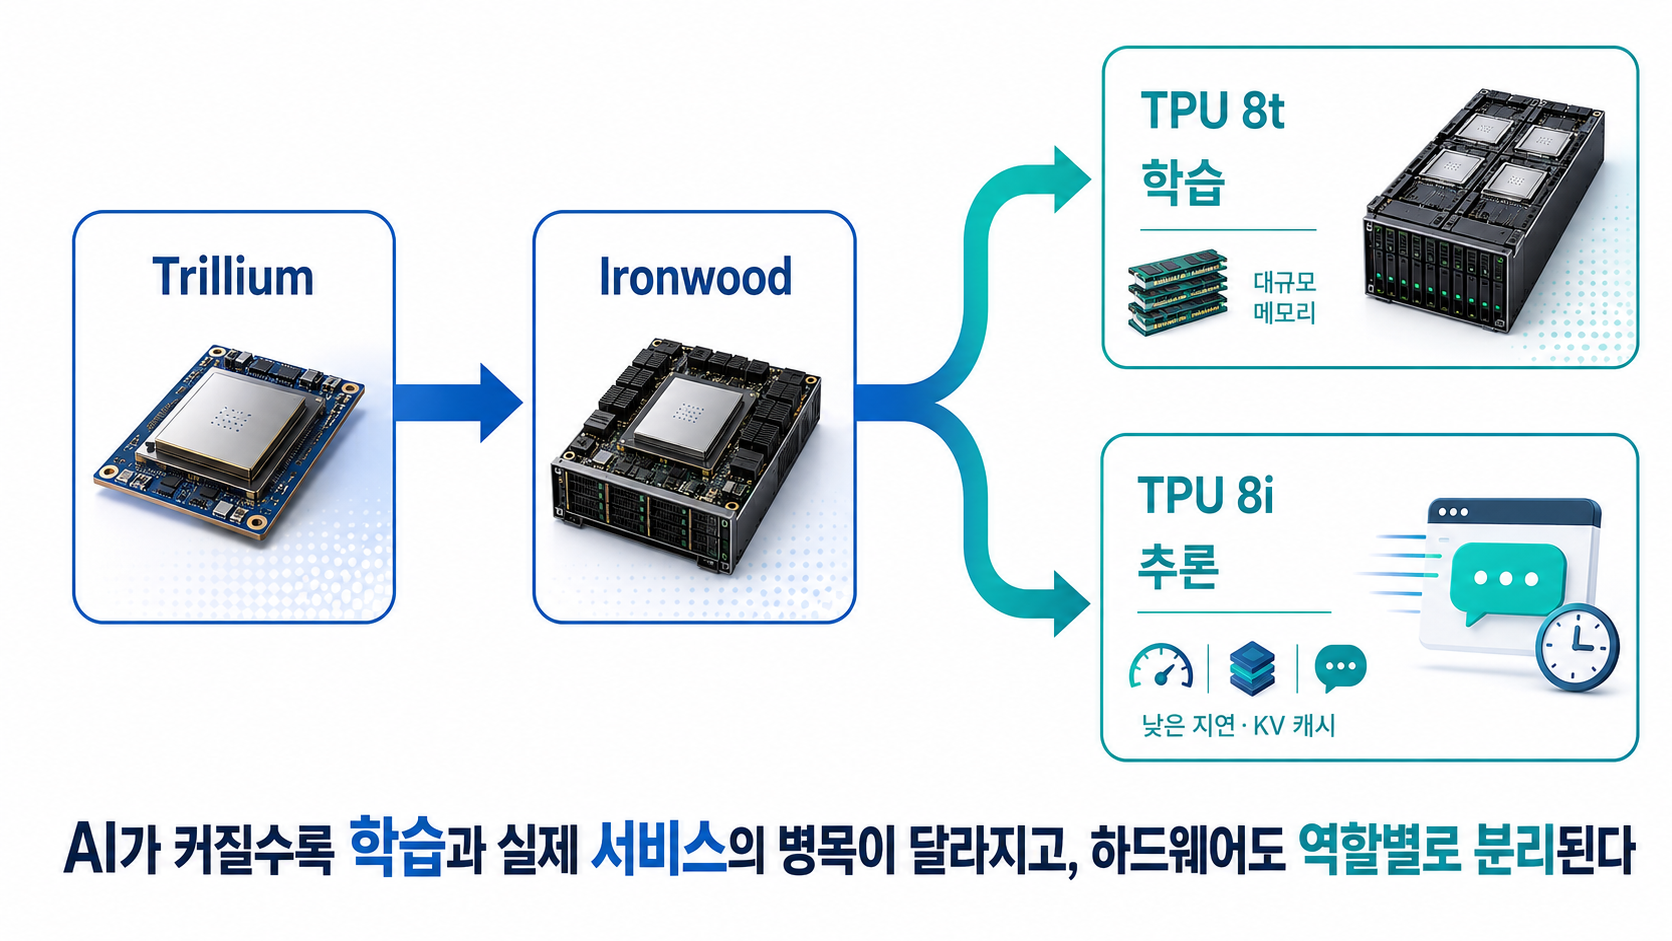
AI를 처음 만드는 학습과, 사용자의 질문에 실제로 답하는 추론은 필요한 하드웨어 특성이 다릅니다.
그래서 Google은 8세대 TPU를 학습용 8t와 추론용 8i로 나누고 있습니다.
핵심은 최고 연산 숫자보다 같은 비용과 전력으로 얼마나 많은 AI 작업을 안정적으로 처리하느냐입니다.
1. Gemini는 모델이고 TPU는 그 모델을 돌리는 기반이다
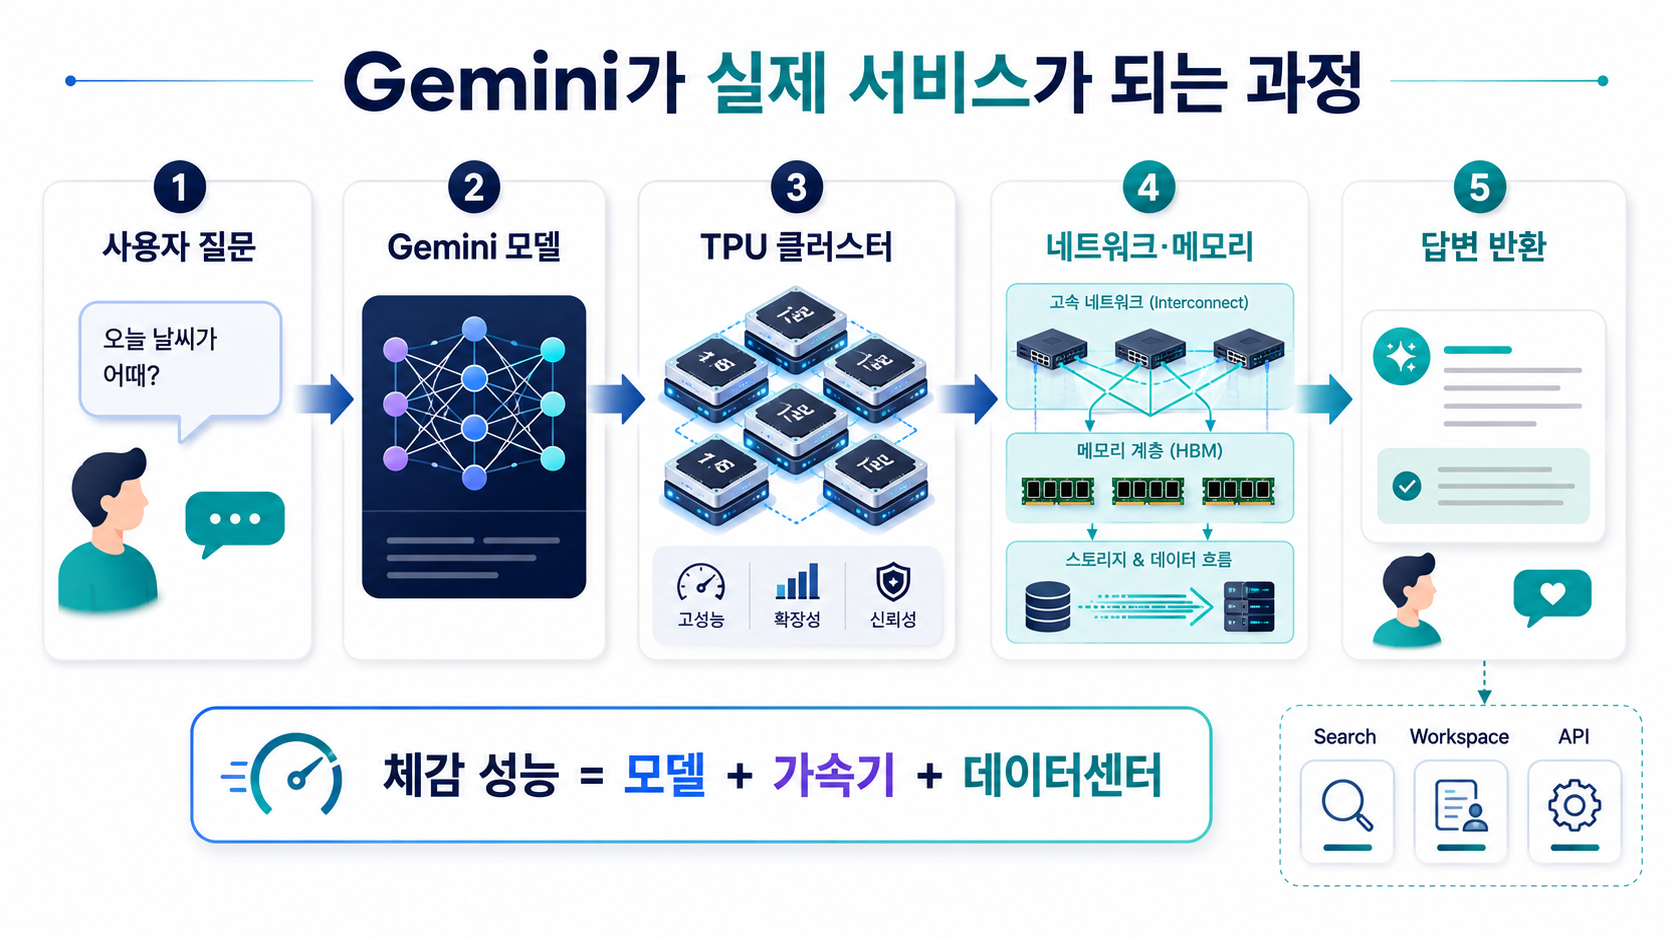
사용자는 Gemini 앱, Search, Workspace, API 같은 화면에서 AI를 만나지만 뒤에서는 모델이 수많은 가속기와 네트워크, 스토리지 위에서 학습되고 추론됩니다.
TPU는 구글이 AI 텐서 연산을 위해 직접 설계한 가속기입니다.
중요한 점은 Gemini가 특정 TPU 한 세대에만 묶여 있다는 뜻이 아니라는 것입니다.
구글은 모델 요구사항을 보면서 하드웨어와 소프트웨어를 함께 개선하고, TPU뿐 아니라 NVIDIA GPU도 사용하는 멀티가속기 전략을 운영합니다.
2. 구글이 자체 TPU를 만드는 이유는 ‘모델과 칩을 함께 바꾸기’ 위해서다
범용 GPU는 다양한 워크로드를 처리할 수 있다는 장점이 있습니다.
반면 구글처럼 AI 요청이 매우 큰 회사는 반복되는 모델 구조와 서비스 패턴을 직접 보면서 가속기 설계를 조정할 수 있습니다.
예를 들어 AI 모델이 커지면 데이터를 빠르게 공급하는 HBM(고대역폭 메모리)이 중요해집니다.
AI가 긴 대화를 이어갈수록 이전 대화 내용을 빠르게 불러오는 KV 캐시도 중요해집니다.
Google은 이런 요구를 TPU·네트워크·소프트웨어와 함께 설계해 칩 한 개가 아니라 전체 AI 시스템의 비용과 속도를 조정하려 합니다.
3. TPU 세대가 학습용과 추론용으로 갈라진 이유
| 세대 | 쉽게 보면 | 현재 위치 |
| Trillium | 학습·추론에 폭넓게 쓰는 6세대 | Google Cloud 일반 제공 |
| Ironwood | 더 큰 AI와 추론을 겨냥한 7세대 | Google Cloud 일반 제공 |
| TPU 8t | 초대형 모델 학습에 특화 | 발표됨·Cloud 제공 확대 예정 |
| TPU 8i | 빠른 추론·에이전트 실행에 특화 | 발표됨·Cloud 제공 확대 예정 |
8세대에서는 학습과 추론의 요구가 크게 달라졌다고 보고 두 칩의 역할을 나눴습니다.
TPU 8t는 수천 개 칩을 묶어 거대한 모델을 학습하는 쪽에, TPU 8i는 사용자에게 빠르게 답을 돌려주는 추론과 에이전트 작업에 더 맞춘 설계입니다. 초보자는 ‘AI를 만드는 칩’과 ‘AI를 서비스하는 칩’이 점점 달라지고 있다고 이해하면 됩니다.
4. 에이전트 시대에는 추론 비용이 더 중요해진다
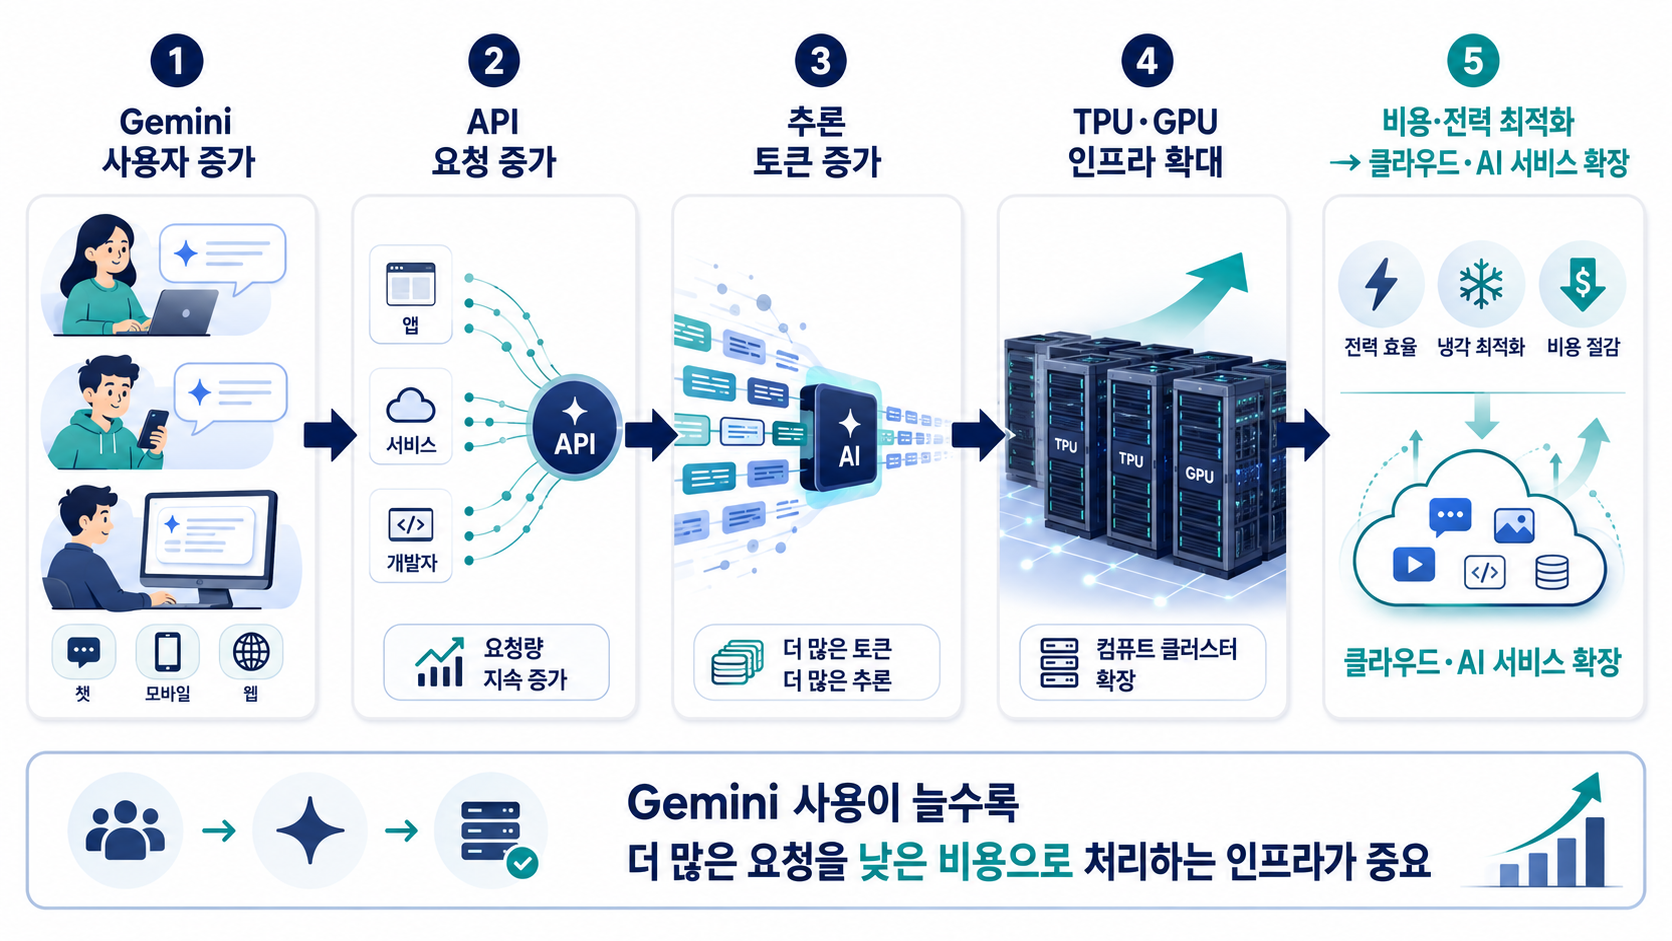
모델 학습은 큰 프로젝트이지만 실제 서비스에서는 사용자의 요청이 매일 반복됩니다.
에이전트는 한 번의 질문에서도 여러 단계의 reasoning, 도구 호출, 검증을 반복할 수 있어 토큰 처리량과 메모리 사용이 크게 늘 수 있습니다.
그래서 실제 AI 서비스에서는 최고 성능 숫자보다 1달러로 얼마나 많은 답변을 만들 수 있는지, 사용자가 얼마나 빨리 답을 받는지, 같은 전력으로 얼마나 많은 요청을 처리하는지가 중요합니다.
모델과 인프라를 함께 최적화하는 이유도 결국 서비스 비용을 낮추기 위해서입니다.
5. 공동설계가 Google에 주는 사업상 이점은 무엇일까
Gemini가 Search·Workspace·Cloud API 같은 여러 서비스로 확산될수록 같은 AI 모델을 반복 실행하는 비용이 커집니다.
이때 자체 TPU와 데이터센터 소프트웨어를 함께 최적화하면 사용량이 늘어날수록 비용을 더 세밀하게 통제할 수 있습니다.
또 Google Cloud 고객에게 TPU를 외부 서비스로 제공하면 자체 칩 투자가 내부 비용 절감뿐 아니라 클라우드 상품의 차별화로도 이어질 수 있습니다.
다만 Cloud 성장 전체를 TPU 하나의 성과로 해석하면 안 되고, 실제 외부 고객 채택과 소프트웨어 사용 편의성을 함께 봐야 합니다.
6. TPU가 있다고 GPU가 필요 없어지는 것은 아니다
구글은 TPU를 키우면서도 NVIDIA GPU를 Cloud의 핵심 가속기 포트폴리오로 계속 제공하고 있습니다.
고객마다 프레임워크, 모델, 라이브러리와 운영 경험이 다르기 때문입니다.
Gemini와 TPU의 공동설계가 강점이라고 해서 TPU가 모든 모델에서 더 빠르거나 더 저렴하다는 뜻은 아닙니다. 실제 결과는 모델 구조, 배치 크기, 프레임워크, 네트워크, 데이터 파이프라인과 리전 가용성에 따라 달라집니다.
정리
Gemini와 TPU의 관계에서 중요한 것은 ‘구글이 자체 칩을 쓴다’는 사실 하나가 아닙니다.
모델 요구사항을 칩·메모리·네트워크·소프트웨어 설계에 다시 반영할 수 있다는 구조가 핵심입니다.
AI가 학습 중심에서 대규모 추론과 에이전트 운영으로 넓어질수록 이 공동설계의 가치도 더 분명하게 시험받게 됩니다.
'AI·소프트웨어' 카테고리의 다른 글
| Big Tech AI 투자 약 7300억달러, 결국 누가 돈을 벌까? 엔비디아·클라우드·전력 수혜주 (0) | 2026.09.08 |
|---|---|
| Meta는 AI 투자로 어떻게 돈을 벌까? 광고·데이터센터 CAPEX·FCF 구조 (0) | 2026.08.30 |
| Oracle OCI는 AI 클라우드에서 왜 강해졌을까? GPU·RDMA·데이터베이스 분석 (0) | 2026.07.11 |
| Supermicro는 AI 서버 시장에서 왜 강할까? 랙스케일·액체냉각·마진 구조 분석 (0) | 2026.07.10 |
| 구글 클라우드는 TPU로 차별화할 수 있을까? (0) | 2026.07.07 |